Gemini 4 Neon no Direito e na advocacia: preços, desempenho e comparativo com GPT-6.2 e Claude 5
Equipe Elden · · 11 min de leitura
 Google Gemini 4 Neon
 OpenAI GPT-6.2
 Anthropic Claude 5
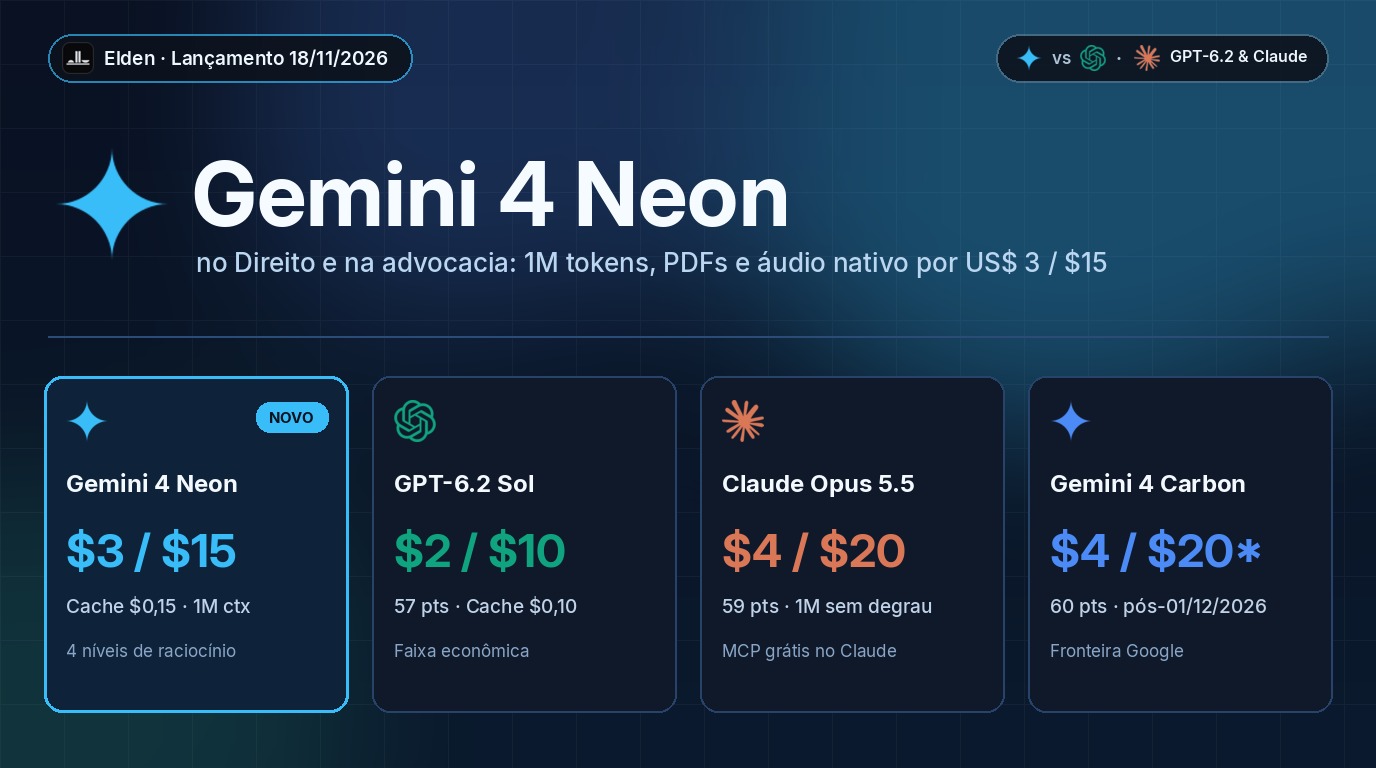
Em resumo: Gemini 4 Neon (18/11/2026) no Direito e na advocacia: US$ 3 / US$ 15 por milhão, janela de 1 milhão de tokens, quatro níveis de raciocínio e cache implícito a US$ 0,15/M. Fica entre o Gemini 4 Hydrogen e o Carbon e, a partir de 01/12/2026, sai 25% mais barato que Carbon e Argon. Até a publicação deste texto, nenhum benchmark independente do modelo tinha saído.
O que o Google lançou com o Gemini 4 Neon em 18 de novembro de 2026?
O Gemini 4 Neon (gemini-4-neon) é o quarto modelo da família Gemini 4, depois de Argon, Carbon e Hydrogen. O Google o apresenta como um modelo de raciocínio rápido, com qualidade "próxima à do Gemini 4 Carbon", mais veloz e mais barato. Os usos indicados são programação, raciocínio e agentes em produção. Segundo a página do modelo no Vertex AI, ele "parte do Gemini 4 Hydrogen com raciocínio mais profundo".
O que já se confirma nas fontes oficiais e nos agregadores:
- Disponibilidade: o modelo aparece na tabela de preços do Google AI Studio e tem guia próprio na documentação do Google Cloud (Gemini Enterprise Agent Platform / Vertex AI). Ali ele está liberado para clientes corporativos verificados, nas regiões
global,useeu. O OpenRouter também já lista o modelo, servido por Google AI Studio e Google Vertex. - Contexto: 1.048.576 tokens unificados. O mesmo limite cobre entrada, raciocínio, chamadas de função e resposta.
- Saída padrão: 65.536 tokens por segmento, com ou sem streaming.
- Long-decode: a saída pode chegar a 1.048.576 tokens menos os tokens de entrada. Funciona pela Interactions API e pelo
GenerateContent(somentev1beta1), com continuação automática no SDK, decodificação em segundo plano (background=true,store=true) ou laços comcontinuation_token. - Níveis de raciocínio:
LOW,MEDIUM,HIGH(o padrão) eXHIGH. Parâmetros comothinking_budgete o nívelMINIMALretornam erro HTTP 400. - Posicionamento oficial: o Neon fica entre o Hydrogen, voltado a laços de agente de alto volume, e o Carbon, voltado a tarefas complexas e longas. Pode trabalhar sozinho ou orquestrar subagentes Hydrogen. Para quem usa o Argon em programação e raciocínio corporativo, o Google recomenda migrar para o Neon.
Desempenho: até a publicação deste texto, nem o Google nem avaliadores independentes divulgaram números do Neon no Artificial Analysis, no SWE-bench ou no GPQA. A única referência é a declaração do próprio Google de que o modelo é "próximo do Carbon". Como base de comparação, o OfficeChai cita os índices do Artificial Analysis para os irmãos: Hydrogen com 54 no raciocínio máximo e Carbon com 59 no lançamento. Enquanto não houver medição independente do Neon, trate a "proximidade com o Carbon" como promessa do fabricante. O próprio Google não informa a data de corte de conhecimento do modelo.
Quanto custa o Gemini 4 Neon frente ao Gemini 4 Hydrogen, Carbon e Argon?
Valores em dólar por milhão de tokens, nível pago padrão, conforme a página oficial de preços do Google AI Studio. O preço de saída já inclui os tokens de raciocínio.
| Modelo | Entrada | Saída | Cache | Nível gratuito | Muda em 01/12/2026? |
|---|---|---|---|---|---|
| Gemini 4 Neon | US$ 3,00 | US$ 15,00 | US$ 0,15 | Não | Não |
| Gemini 4 Hydrogen | US$ 1,50 | US$ 7,50 | US$ 0,075 | Sim | Não |
| Gemini 4 Carbon | US$ 2,00 → US$ 4,00 | US$ 10,00 → US$ 20,00 | US$ 0,10 → US$ 0,20 | Não | Sim, dobra |
| Gemini 4 Argon | US$ 2,00 → US$ 4,00 | US$ 10,00 → US$ 20,00 | US$ 0,10 → US$ 0,20 | Não | Sim, dobra |
Outras modalidades do Neon na mesma página:
- Batch e Flex: US$ 1,50 de entrada, US$ 7,50 de saída e US$ 0,075 de cache.
- Priority: US$ 5,40 de entrada, US$ 27,00 de saída e US$ 0,27 de cache.
Na rota europeia do Vertex, o OpenRouter lista US$ 3,30 / US$ 16,50.
O que muda com o reajuste de 01/12/2026: até 30 de novembro, Carbon e Argon custam US$ 2 / US$ 10 e saem mais baratos que o Neon. A partir de 1º de dezembro passam a US$ 4 / US$ 20, e o Neon fica 25% abaixo deles. Com o Hydrogen, a relação continua a mesma: o Neon custa o dobro por token.
Exemplo prático: um processo digitalizado com cerca de 300 mil tokens, analisado com uma resposta de 10 mil tokens (somando raciocínio e texto), custa no Neon aproximadamente US$ 0,90 de entrada mais US$ 0,15 de saída. Nas perguntas seguintes sobre os mesmos autos, se o prefixo for reaproveitado pelo cache, a entrada cai para cerca de US$ 0,045. Lembre que todo token processado é cobrado, inclusive os de raciocínio. Usar o XHIGH sem necessidade encarece a saída.
Como o Gemini 4 Neon fica diante do GPT-6.2 Astra, GPT-6.2 Sol, Claude Opus 5.5 e Sonnet 5.5?
Preços em dólar por milhão de tokens, na API padrão. Os valores de OpenAI e Gemini Carbon valem para o cenário descrito na tabela. Os da Anthropic vêm da página oficial de preços. Os do GPT-6.2 vêm da cobertura do lançamento de 17/11/2026.
| Modelo | Entrada | Saída | Cache (leitura) | Contexto | Posicionamento |
|---|---|---|---|---|---|
| Gemini 4 Neon | US$ 3,00 | US$ 15,00 | US$ 0,15 | 1.048.576 | Intermediário de raciocínio rápido, "próximo do Carbon" |
| Gemini 4 Carbon (a partir de 01/12) | US$ 4,00 | US$ 20,00 | US$ 0,20 | 1M | Topo de linha do Google para tarefas longas e complexas |
| Gemini 4 Hydrogen | US$ 1,50 | US$ 7,50 | US$ 0,075 | 1M | Rápido e barato, para alto volume |
| GPT-6.2 Astra | US$ 8,00 | US$ 40,00 | US$ 0,40 | 1.050.000 | Modelo de fronteira da OpenAI para "projetos difíceis" |
| GPT-6.2 Sol | US$ 2,00 | US$ 10,00 | US$ 0,10 | 1.050.000 | Eficiente, para o dia a dia e agentes de várias etapas |
| Claude Opus 5.5 | US$ 4,00 | US$ 20,00 | US$ 0,20 | 1M | Modelo de ponta da Anthropic |
| Claude Sonnet 5.5 | US$ 2,00 | US$ 10,00 | US$ 0,10 | 1M | Equilíbrio entre custo e desempenho |
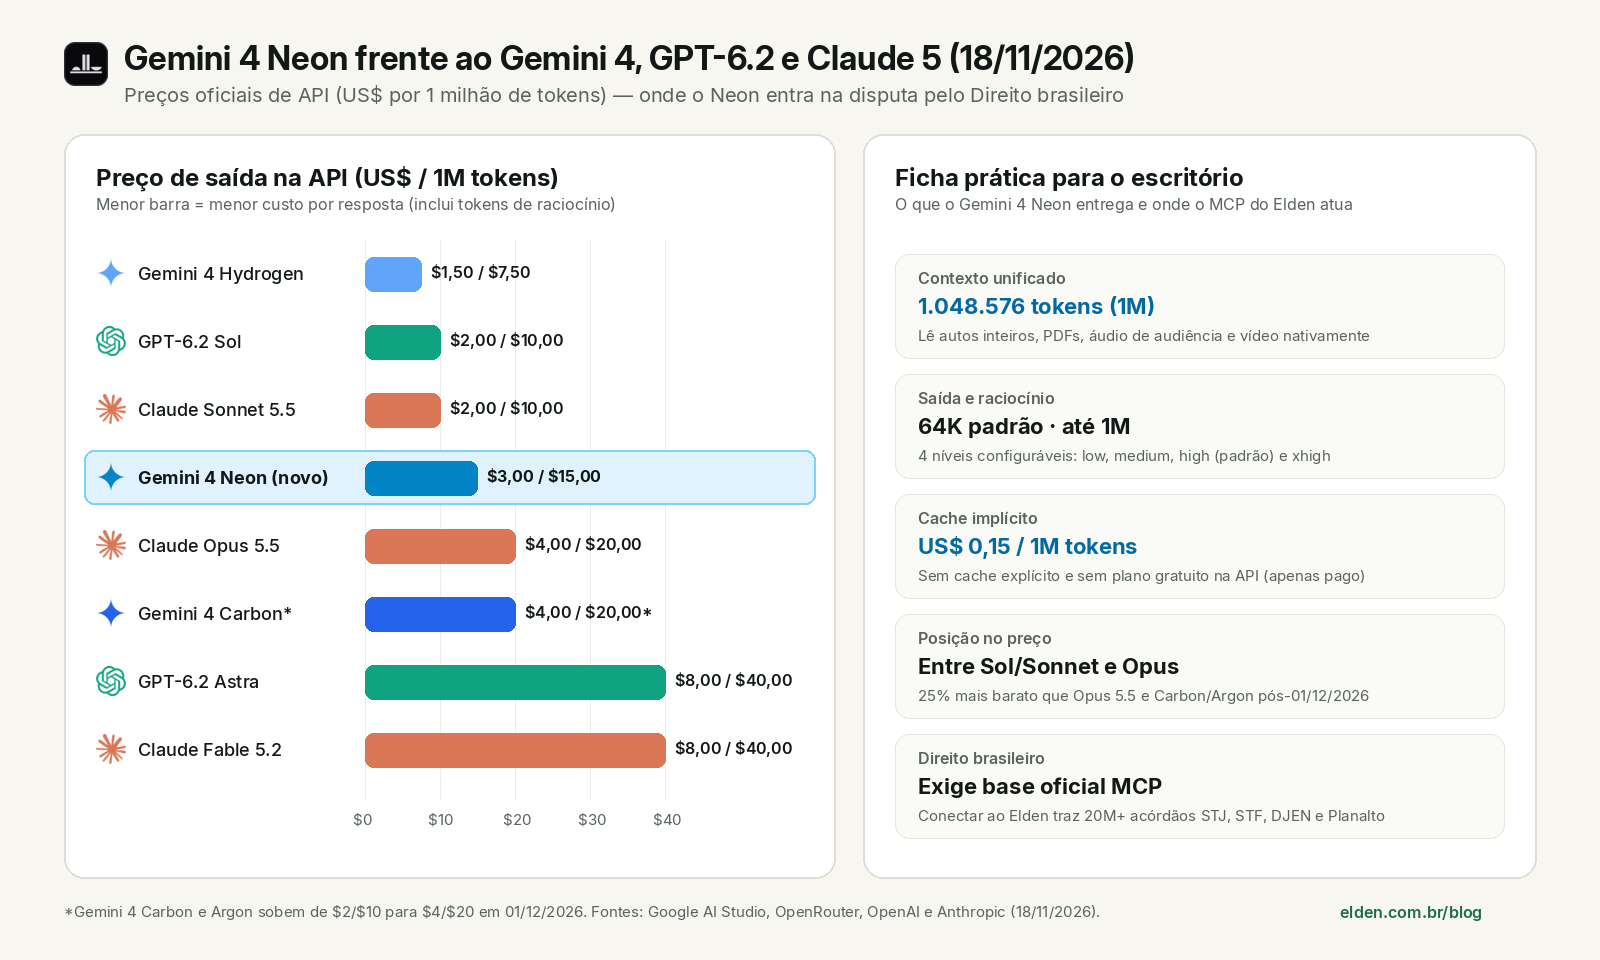
Pontos que importam para o escritório:
- Preço: o Neon custa 50% mais que o GPT-6.2 Sol e o Claude Sonnet 5.5, ambos a US$ 2 / US$ 10. Fica 25% abaixo do Claude Opus 5.5 e do Gemini 4 Carbon pós-reajuste, e bem abaixo do GPT-6.2 Astra.
- Autos volumosos: no GPT-6.2, pedidos acima de 272 mil tokens de entrada têm a entrada e o cache dobrados e a saída multiplicada por 1,5 em todo o pedido. No Astra, isso dá US$ 16 / US$ 60. A tabela do Google para o Neon não traz faixa diferenciada para contexto longo.
- Saída: GPT-6.2, Opus 5.5 e Sonnet 5.5 entregam até 128 mil tokens por resposta. O Neon entrega 65.536 por segmento, mas com long-decode chega perto de 1 milhão.
- Desempenho: a OpenAI publicou avaliações próprias do GPT-6.2 no system card. Para o Neon ainda não existe número publicado. Qualquer ranking entre esses modelos em tarefas jurídicas, hoje, seria especulação.
Quais são os recursos do Gemini 4 Neon mais úteis no Direito brasileiro?
- PDFs nativos e documentos de escritório: o guia oficial lista PDF, texto puro, Word, PowerPoint, Excel e equivalentes OpenDocument, enviados direto na requisição ou pelo Cloud Storage. Dá para mandar a íntegra de autos, contratos e laudos sem converter antes.
- Áudio de audiências: o guia do Neon consultado não detalha a entrada de áudio. Antes de montar um fluxo de transcrição de audiências, teste com um arquivo real e confira a documentação de modalidades do modelo.
- Vídeo: a compreensão de vídeo agêntica está disponível e vem desligada por padrão. Vídeos enviados são processados de forma estática, a menos que você ative o modo agêntico. Isso é útil para gravações de audiência e provas em vídeo.
- 1 milhão de tokens unificados: entrada, raciocínio e resposta dividem a mesma janela. Num processo enorme, sobra menos espaço para a resposta. Planeje o envio dos documentos levando isso em conta.
- Quatro níveis de raciocínio:
LOWeMEDIUMservem para triagem, resumo de publicações e extração de dados.HIGH, o padrão, atende a análise de mérito.XHIGHfica para teses complexas, e consome mais tokens de saída cobrados. - Cache implícito a US$ 0,15/M: é aplicado automaticamente a prefixos repetidos de 4.096 tokens ou mais, sem configuração. O cache explícito não é suportado. Na prática, mantenha os autos no início do prompt e faça as perguntas sempre depois deles.
- Sem nível gratuito: ao contrário do Hydrogen, o Neon não tem uso grátis na API. Todo teste é cobrado.
Como usar o Gemini 4 Neon com jurisprudência brasileira verificada pelo Elden?
Nenhum modelo de linguagem consulta a jurisprudência por conta própria. O que ele "sabe" vem do treino, que termina numa data de corte, e o Google não informou essa data para o Neon. O risco conhecido é a alucinação: número de REsp que não existe, ementa atribuída à turma errada, tese de repetitivo trocada, súmula cancelada citada como vigente. Num processo, isso pode render advertência do juízo e custar a credibilidade do escritório.
A solução é ligar o modelo a uma base verificável. O Elden MCP (https://elden.com.br/mcp) conecta Gemini, ChatGPT, Claude e outros clientes compatíveis com MCP a mais de 20 milhões de acórdãos do STF, do STJ, dos TJs e dos TRFs, coletados via DJEN, além da legislação do Planalto. O modelo deixa de "lembrar" julgados e passa a buscá-los, ler o texto e citar a origem.
Um fluxo seguro:
- Envie os autos ao Gemini 4 Neon e peça a identificação das questões controvertidas.
- Para cada questão, faça o modelo consultar o Elden: legislação, súmulas, temas e acórdãos.
- Exija que cada precedente citado traga número, órgão julgador e data conferidos na base.
- Revise como advogado. A ferramenta reduz o risco, mas não substitui a leitura.
Planos do Elden:
| Plano | Preço | O que inclui |
|---|---|---|
| Grátis | R$ 0, permanente, sem cartão | Uso limitado da pesquisa aprofundada |
| Essencial | R$ 29,90/mês | Pesquisa aprofundada maior; 5 estilos próprios, inclusive a partir de um PDF seu; memória de até 100 anotações; adiantamento de uso |
| Profissional | R$ 69,90/mês | Pesquisa aprofundada máxima; 5 vezes o uso do Essencial; 20 estilos próprios, inclusive a partir de um PDF seu; memória de até 5.000 anotações |
Para criar uma conta: elden.com.br/criar-conta.
Qual modelo escolher em novembro de 2026 para cada tarefa no Direito e na advocacia?
| Tarefa | Sugestão | Por quê |
|---|---|---|
| Triagem de intimações e publicações em volume | Gemini 4 Hydrogen ou GPT-6.2 Sol | Menor custo por token; o Hydrogen ainda tem nível gratuito |
| Análise da íntegra de autos longos | Gemini 4 Neon (HIGH) |
1M de tokens, PDF nativo, sem faixa de preço para contexto longo, cache implícito barato |
| Perguntas sucessivas sobre os mesmos autos | Gemini 4 Neon ou Claude Sonnet 5.5 | O cache reduz o custo de reler o processo |
| Peças complexas e teses novas | Claude Opus 5.5, GPT-6.2 Astra ou Neon em XHIGH |
Topo de linha de cada fabricante; para o Neon ainda faltam benchmarks independentes |
| Relatórios e minutas muito longas numa resposta só | Gemini 4 Neon com long-decode | Saída que passa de 65 mil tokens |
| Uso cotidiano com orçamento apertado | GPT-6.2 Sol ou Claude Sonnet 5.5 | US$ 2 / US$ 10, um terço mais barato que o Neon |
| Qualquer citação de jurisprudência | Qualquer modelo + Elden MCP | Precedente conferido na fonte, não "lembrado" pelo modelo |
Para aprofundar cada família:
- Gemini 4 no Direito e na advocacia
- GPT-6.2 Astra e GPT-6.2 Sol no Direito e na advocacia
- Claude 5 no Direito e na advocacia
Fontes
- https://aistudio.google.com/docs/pricing
- https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon
- https://openrouter.ai/google/gemini-4-neon
- https://nokiapoweruser.com/gemini-4-neon-release-today-google-cloud-pricing/
- https://officechai.com/ai/gemini-4-neon-to-be-googles-fast-reasoning-model-close-to-gemini-4-carbon-at-a-lower-price-and-faster-speed/
- https://www.datastudios.org/post/openai-gpt-6-2-astra-sol-launch-api-pricing-chatgpt-codex
- https://platform.claude.com/docs/en/about-claude/pricing
- https://platform.claude.com/docs/en/models/opus-5-5
- https://elden.com.br
- https://elden.com.br/criar-conta
- https://github.com/magmonte/elden-mcp
Leia também
 ClaudeOpenAIGemini
 DeepSeek
Famílias de IA no Direito e na advocacia (novembro de 2026): mapa técnico completo por provedor
 ClaudeOpenAIGemini
 Kimi
Melhores modelos de IA para Direito e advocacia em novembro de 2026: Gemini 4, Claude 5, GPT-6.2, Muse e DeepSeek
 ClaudeChatGPT
 Elden MCP
MCP de jurisprudência brasileira no Direito e na advocacia: guia prático para Claude e ChatGPT
Um conector que leva leis, súmulas e decisões dos tribunais brasileiros para dentro do ChatGPT, Claude ou Gemini, com número e link. Tem plano grátis permanente.
Sobre este texto: produzido com auxílio de inteligência artificial a partir das fontes indicadas, com conferência automática de números, tribunais e links. Conteúdo informativo, sem caráter de aconselhamento jurídico. Encontrou um erro? [email protected].