Famílias de IA em novembro de 2026: mapa técnico completo por provedor e projeções para a advocacia
Equipe Elden · · 19 min de leitura
Em resumo: Em novembro de 2026, cinco grupos de provedores disputam a advocacia: Google Gemini, Anthropic Claude, OpenAI GPT, Meta Muse e laboratórios asiáticos de pesos abertos. Este mapa reúne contexto, preço, índice no Artificial Analysis e tempo de resposta de cada família, com dados conferidos em 17/11/2026 nas páginas oficiais dos provedores, no OpenRouter e no Artificial Analysis. Ele abre a série por provedor.
Como ler este mapa
Cada provedor entrega hoje uma família inteira, com um modelo topo de linha para raciocínio longo, um intermediário para o trabalho diário e um modelo barato para volume. Para o escritório, a escolha certa depende da tarefa: recurso extraordinário pede profundidade, triagem de intimações pede preço baixo e resposta rápida.
Todos os preços estão em dólares por milhão de tokens (US$/M), separados entre entrada (o que você envia ao modelo) e saída (o que ele escreve). Cache é o preço cobrado quando o mesmo trecho de contexto já foi enviado antes, situação comum quando a mesma pasta de autos é consultada várias vezes. Salvo indicação, o preço é o da API do próprio fabricante na faixa padrão (sem lote, sem prioridade).
O Intelligence Index e os tempos vêm do leaderboard do Artificial Analysis, com o nível de esforço testado entre parênteses. O Artificial Analysis passou a destacar o tempo por tarefa (quanto leva para concluir a bateria de testes, com raciocínio incluído) e o tempo até o primeiro token de resposta, no lugar de tokens por segundo. Para um escritório, isso mede melhor a espera real: um modelo que gera muitos tokens por segundo pode demorar mais para entregar a peça se pensa por muito tempo antes.
| Família | Topo de linha | Intermediário | Volume e custo baixo | Elden |
|---|---|---|---|---|
| Google Gemini | Gemini 4 Carbon | Gemini 4 Hydrogen / Argon | Gemini 3.8 Flash | API com cliente MCP; conectores na web em teste |
| Anthropic Claude | Claude Fable 5.2 | Claude Opus 5.5 / Sonnet 5.5 | Claude Haiku 5.5 | Todos os planos, inclusive o gratuito |
| OpenAI GPT | GPT-6 Astra | GPT-6.1 Sol / GPT-5.5 | GPT-6.1 Terra / GPT-6 Luna | ChatGPT Pro, Business, Enterprise e Edu na web |
| Meta Muse | Muse Wonder | Muse Spark 1.3 / Spark Open | Muse Ember | Depende do cliente MCP usado |
| Asiáticas e pesos abertos | Kimi K3.1 Pro / Qwen4-Max | GLM-5.3 / DeepSeek V4 Pro / MiniMax M3 | DeepSeek V4.1 Flash / GLM-5.3 Flash / M3.1 Flash | Depende do cliente MCP usado |
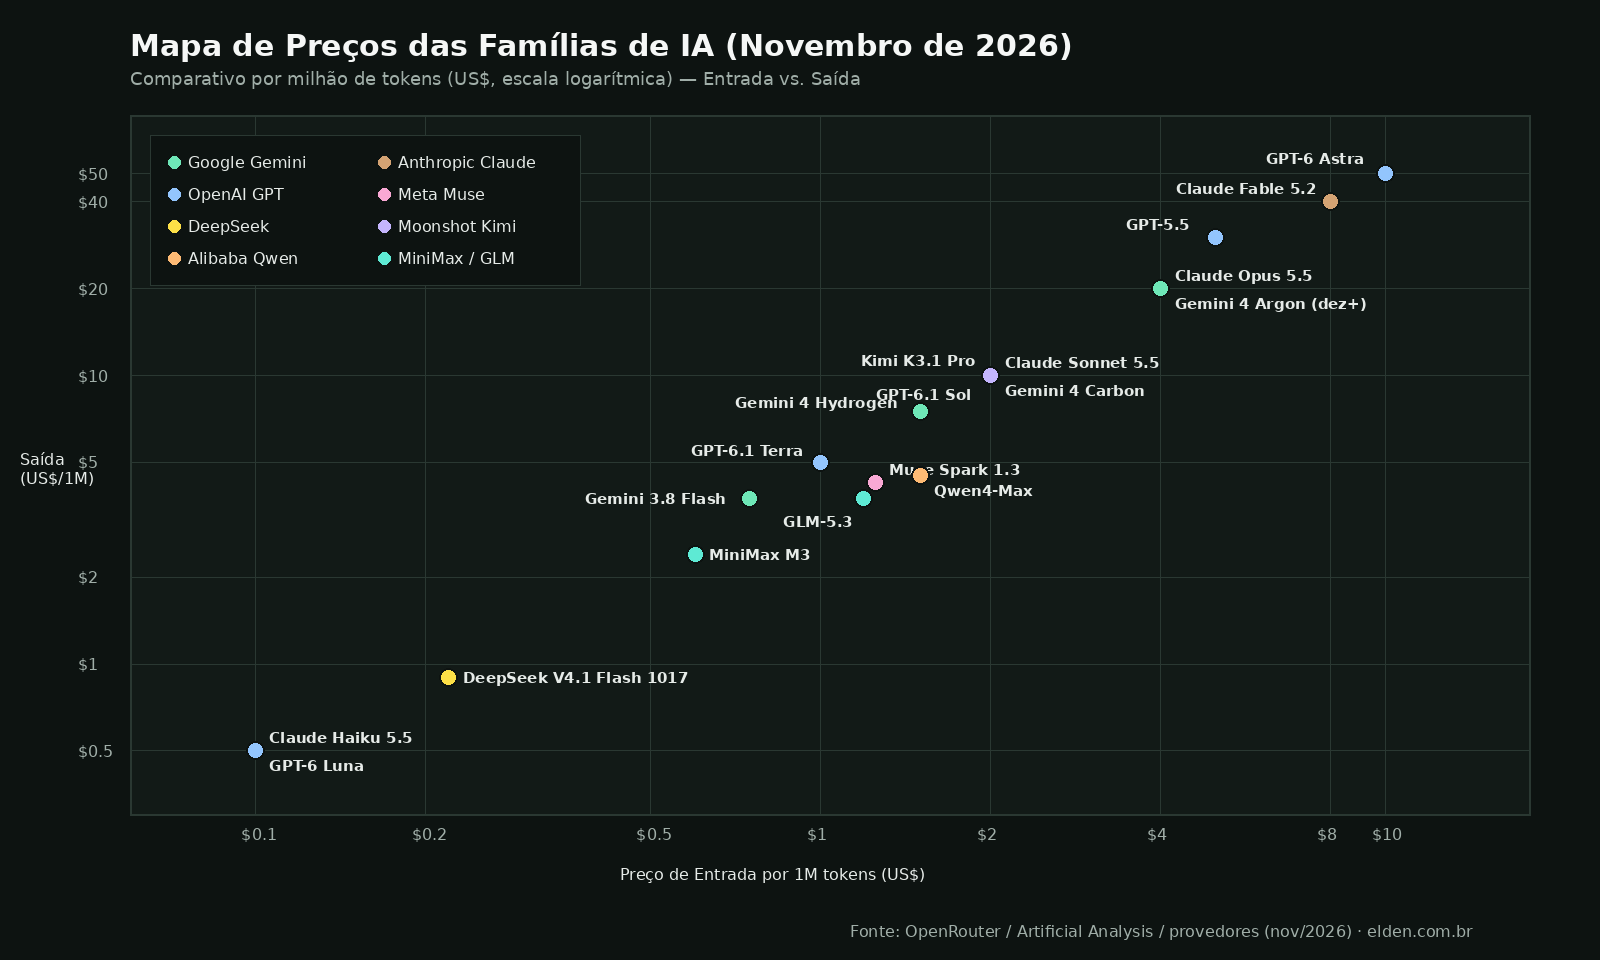
Ranking geral no Artificial Analysis
Antes de olhar família por família, vale a fotografia do leaderboard. A tabela traz os modelos deste mapa que aparecem lá, ordenados pelo índice.
| Modelo (esforço) | Intelligence Index | Custo por tarefa (US$) | Tempo por tarefa (min) | Primeiro token (s) |
|---|---|---|---|---|
| Claude Fable 5.2 (Max) | 65 | 26,54 | 40,9 | 207,86 |
| Gemini 4 Carbon (High) | 60 | 5,48 | 31,8 | 72,30 |
| Claude Opus 5.5 (Max) | 59 | 10,04 | 24,6 | 355,30 |
| GPT-6 Astra (Max) | 57 | 6,24 | 20,2 | 198,40 |
| Claude Sonnet 5.5 (Max) | 55 | 10,02 | 31,1 | 283,74 |
| GPT-6.1 Sol (Max) | 55 | 1,27 | 22,7 | 156,92 |
| Gemini 4 Hydrogen (Xhigh) | 54 | 3,16 | 15,6 | 51,74 |
| GPT-6.1 Terra (Max) | 51 | 0,96 | 13,9 | 148,01 |
| Gemini 4 Argon (High) | 50 | 4,97 | 29,4 | 44,04 |
| Kimi K3.1 Pro | 46 | 3,68 | 38,9 | 152,69 |
| Muse Wonder (Max) | 44 | 6,95 | 13,0 | 19,04 |
| Qwen4-Max | 43 | 3,27 | 32,1 | 159,36 |
| Claude Haiku 5.5 (Max) | 36 | 0,41 | 14,7 | 184,29 |
| Muse Ember (Max) | 36 | 0,14 | 3,2 | 4,96 |
| DeepSeek V4.1 Flash 1017 (Max) | 33 | 0,60 | 13,0 | 40,43 |
| GLM-5.3 (Max) | 32 | 5,01 | 22,1 | 60,33 |
| MiniMax M3.1 Flash | 29 | 0,49 | 15,9 | 46,82 |
| GPT-6 Luna (Max) | 28 | 0,15 | 12,2 | 68,75 |
| GLM-5.3 Flash | 28 | 0,58 | 39,1 | 80,42 |
| Muse Spark Open (Xhigh) | 25 | 2,02 | 6,0 | 9,80 |
| DeepSeek V4 Pro 0813 (Max) | 23 | 1,77 | 17,3 | 50,00 |
| MiniMax M3 | 19 | 1,29 | 13,2 | 65,60 |
Três leituras saltam da tabela. O GPT-6.1 Sol empata com o Claude Sonnet 5.5 no índice (55) e custa cerca de oito vezes menos por tarefa no teste. O Muse Ember entrega o mesmo índice do Haiku 5.5 (36) em 3,2 minutos por tarefa, contra 14,7. E nas linhas asiáticas a versão Flash supera a Pro em mais de um caso: o MiniMax M3.1 Flash (29) fica acima do M3 (19), e o DeepSeek V4.1 Flash (33) fica acima do V4 Pro 0813 (23).
O Muse Wonder Full aparece com índice 50, sem custo por tarefa publicado. Gemini 3.8 Flash, Muse Spark 1.3, GPT-5.5 na versão padrão e Kimi K3 não constavam no leaderboard na data da consulta.
Família Google Gemini
O Google organiza a geração Gemini 4 com nomes de elementos químicos. O Carbon lidera em inteligência (60), o Hydrogen troca alguns pontos de índice (54) por preço 25% menor e o menor tempo por tarefa da família, e o Argon fica abaixo dos dois no índice (50) com o mesmo preço do Carbon. O Artificial Analysis registra contexto de 1M para os três; o OpenRouter lista o Hydrogen com 1,05M.
| Modelo | Intelligence Index | Entrada (US$/M) | Saída (US$/M) | Cache (US$/M) | Lote/Flex (entrada / saída) |
|---|---|---|---|---|---|
| Gemini 4 Carbon (até 30/11/2026) | 60 (High) | 2,00 | 10,00 | 0,10 | 1,00 / 5,00 |
| Gemini 4 Carbon (a partir de 01/12/2026) | 60 (High) | 4,00 | 20,00 | 0,20 | 2,00 / 10,00 |
| Gemini 4 Hydrogen | 54 (Xhigh) | 1,50 | 7,50 | 0,075 | 0,75 / 3,75 |
| Gemini 4 Argon (até 30/11/2026) | 50 (High) | 2,00 | 10,00 | 0,10 | 1,00 / 5,00 |
| Gemini 4 Argon (a partir de 01/12/2026) | 50 (High) | 4,00 | 20,00 | 0,20 | 2,00 / 10,00 |
| Gemini 3.8 Flash (até 31/12/2026) | não listado | 0,75 | 3,75 | 0,075 | 0,375 / 1,875 |
| Gemini 3.8 Flash (a partir de 01/01/2027) | não listado | 1,50 | 7,50 | 0,15 | 0,75 / 3,75 |
A tabela de preços do Google AI Studio traz três datas que mexem no orçamento. Carbon e Argon dobram de preço em 01/12/2026. O Gemini 3.8 Flash dobra em 01/01/2027 e cobra ainda armazenamento de cache de US$ 0,50 por milhão de tokens por hora até o fim de 2026, subindo para US$ 1,00 depois. O Hydrogen é o único sem reajuste programado.
O cache dos quatro modelos é só implícito: não há cache explícito, então o escritório não escolhe o que fica guardado. A faixa Priority custa 1,8 vez a padrão (no Carbon, US$ 3,60 e US$ 18,00 antes do reajuste).
Alerta de sigilo: Hydrogen e 3.8 Flash têm uso gratuito no plano free do AI Studio, e o Google informa que o conteúdo enviado nesse plano é usado para melhorar os produtos dele. Autos com dados de cliente não devem passar pelo plano gratuito.
Para o Elden, os conectores personalizados na web do Gemini ainda estão em teste. Hoje a ligação estável passa pela API com um cliente MCP.
Projeção para a advocacia: o Carbon tem o segundo maior índice deste mapa e o menor custo por tarefa entre os modelos acima de 55, o que o torna candidato natural a peças complexas com autos inteiros no contexto. Esse ganho dura até 30/11/2026: com o preço dobrado, o Carbon passa a cobrar por token o mesmo que o Opus 5.5. O Hydrogen atende carga contínua, como leitura diária de publicações, e fica com a melhor relação de preço da família a partir de dezembro.
Família Anthropic Claude
A Anthropic padronizou a família Claude 5 com contexto de 1 milhão de tokens e 128 mil de saída em todos os modelos, inclusive o Haiku. No Batch API, Opus 5.5, Sonnet 5.5 e Haiku 5.5 aceitam até 300 mil tokens de saída com cabeçalho beta, o que cabe numa peça longa inteira. O corte de conhecimento confiável dos quatro é junho de 2026.
| Modelo | Intelligence Index | Entrada (US$/M) | Saída (US$/M) | Cache, leitura (US$/M) | Lote (entrada / saída) | Esforço padrão |
|---|---|---|---|---|---|---|
| Claude Fable 5.2 | 65 (Max) | 8,00 | 40,00 | 0,20 | 4,00 / 20,00 | high |
| Claude Opus 5.5 | 59 (Max) | 4,00 | 20,00 | 0,20 | 2,00 / 10,00 | medium |
| Claude Sonnet 5.5 | 55 (Max) | 2,00 | 10,00 | 0,10 | 1,00 / 5,00 | high |
| Claude Haiku 5.5, prompt até 100 mil tokens | 36 (Max) | 0,10 | 0,50 | 0,01 | 0,05 / 0,25 | medium |
| Claude Haiku 5.5, prompt acima de 100 mil tokens | 36 (Max) | 0,50 | 2,50 | 0,05 | 0,25 / 1,25 | medium |
O cache da Anthropic ficou bem mais barato nesta geração. A leitura de cache custa 2,5% do preço de entrada no Fable 5.2 e 5% no Opus 5.5 e no Sonnet 5.5, contra 10% nos modelos anteriores. Na prática, consultar de novo a mesma pasta de autos no Opus 5.5 custa US$ 0,20 por milhão de tokens. A escrita de cache por 5 minutos sai por 1,25 vez o preço de entrada, e por 1 hora por 2 vezes.
O Haiku 5.5 cobra por faixa: até 100 mil tokens de prompt valem os preços menores; acima disso, a requisição inteira passa para a faixa cara, mesmo que parte do prompt venha do cache. Em triagem de intimações, quase todo pedido fica na primeira faixa. Nos demais modelos da família, o contexto de 1M sai pelo preço padrão: um pedido de 900 mil tokens paga a mesma tarifa por token de um pedido de 9 mil.
Fable 5.2 e Opus 5.5 têm modo rápido (fast mode), com até 2,5 vezes mais tokens de saída por segundo, cobrado a US$ 16 e US$ 80 no Fable e a US$ 8 e US$ 40 no Opus. Pedir inferência só nos Estados Unidos aplica multiplicador de 1,1 vez sobre todos os preços.
A compatibilidade com o Elden é a mais ampla do mercado: o conector funciona em todos os planos do Claude, inclusive o gratuito.
Projeção para a advocacia: o Fable 5.2 tem o maior índice do mapa (65) e se justifica em pareceres e estratégias de caso longas, onde o custo por tarefa (US$ 26,54 no teste) pesa menos que o acerto. O Opus 5.5 é o modelo que a própria Anthropic indica como ponto de partida e tende a ser o padrão para recursos e peças fora do modelo. O Sonnet 5.5 cobre o volume de petições intermediárias, e o Haiku 5.5 a classificação e o resumo de publicações.
Família OpenAI GPT
A OpenAI mantém duas gerações em paralelo. A linha GPT-6 traz nomes astronômicos, com o Astra no topo e o Luna na base, e a revisão 6.1 entrega o Sol e o Terra nas faixas média e econômica. O GPT-5.5 segue ativo na API.
| Modelo | Contexto / entrada máx. / saída | Intelligence Index | Entrada (US$/M) | Saída (US$/M) | Cache (US$/M) |
|---|---|---|---|---|---|
| GPT-6 Astra | 1.050.000 / 922.000 / 128.000 | 57 (Max) | 10,00 | 50,00 | 1,00 |
| GPT-5.5 | não informado na página de preços | não listado | 5,00 | 30,00 | 0,50 |
| GPT-6.1 Sol | 1.050.000 / 922.000 / 128.000 | 55 (Max) | 2,00 | 10,00 | 0,10 |
| GPT-6.1 Terra | 1M (Artificial Analysis) | 51 (Max) | 1,00 | 5,00 | 0,05 |
| GPT-6 Luna | 1M (Artificial Analysis) | 28 (Max) | 0,10 | 0,50 | 0,01 |
Os preços da tabela valem para prompts de até 272 mil tokens de entrada. Acima disso, Astra e Sol cobram o dobro na entrada e no cache e 1,5 vez na saída, sobre a requisição inteira. Na tabela de contexto longo, a entrada passa a US$ 20 no Astra, US$ 4 no Sol, US$ 2 no Terra, US$ 0,20 no Luna e US$ 10 no GPT-5.5. Para quem joga autos completos no modelo, esse limite de 272 mil tokens é o número que mais importa na OpenAI.
Lote e Flex custam metade do padrão. O modo Fast (antigo Priority) custa o dobro. O Astra e o Sol têm corte de conhecimento em 30/04/2026 e cinco níveis de esforço de raciocínio, de low a max.
Atenção à nomenclatura: o modelo barato é o GPT-6 Luna, sem a revisão 6.1. Scripts e integrações que chamam "GPT-6.1 Luna" vão falhar.
No Elden, o conector funciona na web do ChatGPT nos planos Pro, Business, Enterprise e Edu. Os planos Free e Plus ficam de fora, assim como o aplicativo.
Projeção para a advocacia: o Astra é o modelo mais caro por token deste mapa e fica reservado a casos de alto valor. O Sol é a melhor relação de preço da OpenAI: mesmo preço por token do Sonnet 5.5, mesmo índice, e o menor custo por tarefa entre os modelos com índice 55 ou mais no teste do Artificial Analysis. O Terra cai para US$ 0,96 por tarefa com índice 51. O Luna disputa com o Haiku 5.5 a triagem em massa, com índice menor (28 contra 36).
Família Meta Muse: Wonder, Spark 1.3, Ember e Spark Open
A Meta migrou sua linha principal do antigo selo Llama para a família Muse, desenvolvida pela Meta Superintelligence Labs. Em outubro de 2026 a empresa lançou o Muse Wonder como modelo fechado de ponta e abriu os pesos do Muse Spark Open (15/10/2026, 816B parâmetros no total e 42B ativos, contexto de 1M).
| Modelo | Pesos | Intelligence Index | Entrada (US$/M) | Saída (US$/M) | Observação |
|---|---|---|---|---|---|
| Muse Wonder | Fechado | 44 (Max) | 4,00 | 20,00 | Wonder Full marca 50, sem preço de API |
| Muse Spark 1.3 | Fechado | não listado | 1,25 | 4,25 | Variante contributor treina nos prompts |
| Muse Ember | Fechado | 36 (Max) | 0,10 | 0,50 | 3,2 min por tarefa, o mais rápido do mapa |
| Muse Spark Open | Aberto (Muse Model License) | 25 (Xhigh) | 1,25 | 4,25 | Preço em Together, Fireworks, Baseten e outros |
Os preços são os listados no OpenRouter para a API da própria Meta e para o Google Vertex. O Muse Wonder Full, versão maior do Wonder, não tem preço de token publicado na API; aparece em planos do Muse Code.
O Muse Ember é o achado desta rodada. Com o mesmo preço por token do Haiku 5.5 e o mesmo índice (36), ele conclui a bateria do Artificial Analysis em 3,2 minutos e entrega o primeiro token em menos de 5 segundos. Para triagem com resposta imediata, é o modelo a testar.
Alerta de sigilo e LGPD: a variante muse-spark-1.3-contributor custa US$ 0,10 e US$ 0,20 justamente porque a Meta treina com os prompts e as respostas enviados, segundo guias técnicos publicados no lançamento. Dados de cliente, segredo de justiça e peças em elaboração não devem passar por ela. A licença do Muse Spark Open não é uma licença aberta comum: permite uso comercial até um teto de receita de US$ 20 milhões, exige atribuição e pede o selo "Built with Muse Spark Open" em produtos que o usem, ponto que importa a quem pretende hospedá-lo para terceiros.
Projeção para a advocacia: o Muse Wonder consolida a aposta da Meta no topo fechado, com índice abaixo dos líderes de Google, Anthropic e OpenAI. O Ember é forte candidato para classificação de publicações em tempo real. O Spark Open interessa a escritórios que precisam rodar o modelo em servidor dedicado, desde que a licença caiba no faturamento. A escolha da variante correta e a revisão contratual antes do envio de dados de cliente são obrigatórias.
Famílias asiáticas e de pesos abertos
DeepSeek, Moonshot (Kimi), Alibaba (Qwen), Z.ai (GLM) e MiniMax formam o grupo com os menores preços do mercado e a maior oferta de pesos abertos. Quase todos aparecem com contexto de 1M no Artificial Analysis, e como os pesos estão disponíveis, dezenas de provedores revendem o mesmo modelo por preços muito diferentes no OpenRouter.
| Provedor | Modelo | Intelligence Index | Preço do fabricante (entrada / saída, US$/M) | Faixa no OpenRouter (entrada) | Observação |
|---|---|---|---|---|---|
| DeepSeek | V4.1 Flash 1017 | 33 (Max) | 0,30 / 1,20 (Google Vertex, Together, Fireworks) | 0,051 a 3,00 | Atende pelo nome deepseek-flash |
| DeepSeek | V4 Pro | 23 (Max, versão 0813) | não publicado no OpenRouter | 0,90 a 1,95 | OpenRouter lista a versão 0423 |
| Moonshot | Kimi K3 | não listado | 3,00 / 15,00 | 0,153 a 4,50 | Também no Amazon Bedrock |
| Moonshot | Kimi K3.1 Pro | 46 | 2,00 / 10,00 | 0,24 a 4,00 | Pesos abertos; maior índice do grupo |
| Alibaba | Qwen4-Max | 43 | 1,425 / 4,275 (Alibaba Cloud Int.) | só Alibaba listado | Contexto de 984 mil no Artificial Analysis |
| Z.ai | GLM-5.3 | 32 (Max) | 1,40 / 4,40 | 0,07 a 2,10 | Mais de 40 revendedores |
| Z.ai | GLM-5.3 Flash | 28 | 0,15 / 0,50 | 0,04 a 0,225 | Versão de volume |
| MiniMax | MiniMax M3 | 19 | 0,30 / 1,20 | 0,224 a 0,45 | Índice abaixo da própria versão Flash |
| MiniMax | M3.1 Flash | 29 | 0,15 / 0,60 | 0,075 a 0,15 | Cobrança por horário (UTC) |
A documentação da DeepSeek informa que deepseek-flash hoje é servido pelo DeepSeek-V4.1-Flash-1017 e que os nomes antigos deepseek-v4-flash e deepseek-v4-flash-vision-exp continuam aceitos, mas os modelos foram aposentados: as chamadas vão para o 1017 e são cobradas pelo preço do Flash. Quem tem integração antiga já está usando o modelo novo sem saber.
O Qwen4-Max ainda está em pré-visualização. A imprensa técnica relata acesso pelo Token Plan da Alibaba entre 11 e 25 de novembro, sem ficha técnica, contagem de parâmetros ou pesos publicados. O preço do OpenRouter vem do Alibaba Cloud Internacional, único provedor listado.
Duas cobranças mudam conforme o horário: a do M3.1 Flash na própria MiniMax e a do V4.1 Flash no Alibaba Cloud. Para quem roda lotes noturnos de extração, vale conferir a tabela por faixa de horário antes de agendar.
Projeção para a advocacia: este grupo atende bem rotinas de alto volume, como extração de dados de extratos e classificação de publicações. O Kimi K3.1 Pro (46) supera o Muse Wonder (44) em índice pela metade do preço de entrada na Moonshot. Modelos de pesos abertos (GLM, DeepSeek, Kimi) permitem hospedagem própria. Nos revendedores do OpenRouter, o preço mais baixo costuma vir de provedor pequeno ou de quantização reduzida, e a política de retenção de dados muda de um para outro; deve ser lida antes de enviar autos com dados pessoais.
O que todas as famílias têm em comum: acervo oficial
Nenhum dos modelos deste mapa conhece, por si, a jurisprudência brasileira atualizada. Os cortes de conhecimento declarados param em abril (OpenAI) e junho de 2026 (Anthropic), e todos podem errar números de processo e inventar ementas quando trabalham só com a memória do treino. A precisão em peça jurídica depende de acervo oficial consultado no momento da redação, e é esse acervo que o Elden entrega via MCP.
O Elden conecta qualquer cliente compatível ao endereço https://elden.com.br/mcp, com mais de 20 milhões de acórdãos do STF, STJ, TJs e TRFs, publicações do DJEN e legislação do Planalto. A busca usa a primeira geração de IAs próprias de rerank e embedding, treinadas para o texto jurídico brasileiro. O plano grátis é permanente, custa R$ 0, não pede cartão e funciona com janelas de uso de 5 horas e semanais. A documentação e os manifestos de conexão para cada cliente estão em https://github.com/magmonte/elden-mcp.
Este texto abre uma série. Cada família terá um artigo próprio com projeções detalhadas para o escritório: Gemini, Claude, GPT, Muse e o grupo asiático de pesos abertos. Em todos eles, o critério de teste será o mesmo: o modelo ligado ao acervo oficial do Elden, respondendo com fonte conferível.
Fontes
- https://elden.com.br
- https://github.com/magmonte/elden-mcp
- https://elden.com.br/criar-conta
- https://artificialanalysis.ai/leaderboards/models
- https://artificialanalysis.ai/models
- https://artificialanalysis.ai/methodology/performance-benchmarking
- https://hermes-ai.net/news/artificial-analysis-ditches-tokens-per-second-to-rank-ai-speed/
- https://openrouter.ai/models
- https://openrouter.ai/google/gemini-4-carbon
- https://openrouter.ai/google/gemini-3.8-flash
- https://openrouter.ai/anthropic/claude-fable-5.2
- https://openrouter.ai/openai/gpt-6-astra
- https://openrouter.ai/meta/muse-wonder
- https://openrouter.ai/meta/muse-spark-1.3
- https://openrouter.ai/meta/muse-ember
- https://openrouter.ai/meta/muse-spark-open
- https://openrouter.ai/deepseek/deepseek-v4.1-flash
- https://openrouter.ai/deepseek/deepseek-v4-pro
- https://openrouter.ai/moonshotai/kimi-k3
- https://openrouter.ai/moonshotai/kimi-k3.1-pro
- https://openrouter.ai/qwen/qwen4-max
- https://openrouter.ai/z-ai/glm-5.3
- https://openrouter.ai/z-ai/glm-5.3-flash
- https://openrouter.ai/minimax/minimax-m3
- https://openrouter.ai/minimax/minimax-m3.1-flash
- https://aistudio.google.com/docs/pricing
- https://platform.claude.com/docs/en/about-claude/pricing
- https://platform.claude.com/docs/en/about-claude/models/overview
- https://developers.openai.com/api/docs/pricing
- https://developers.openai.com/api/docs/models/gpt-6-astra
- https://developers.openai.com/api/docs/models/gpt-6.1-sol
- https://api-docs.deepseek.com/quick_start/pricing
- https://www.deeplearning.ai/the-batch/meta-releases-wonder-opens-spark/
- https://thenewstack.io/meta-muse-spark-open/
- https://www.nocode.mba/ai-release-tracker/releases/meta-muse-spark-open
- https://www.datacamp.com/tutorial/muse-spark-1-3-tutorial
- https://miraflow.ai/blog/meta-muse-spark-1-3-contributor-tier-explained-2026
- https://docs.litellm.ai/blog/muse_spark_1_3
- https://magica.com/news/alibaba-qwen4-max-preview-token-plan
- https://alphasignal.ai/news/alibaba-launches-qwen4-max-with-agent-first-coding-and-1m-token-support
- https://www.datalearner.com/ai-models/pretrained-models/qwen4-max
Um conector que leva leis, súmulas e decisões dos tribunais brasileiros para dentro do ChatGPT, Claude ou Gemini, com número e link. Tem plano grátis permanente.
Sobre este texto: produzido com auxílio de inteligência artificial a partir das fontes indicadas, com conferência automática de números, tribunais e links. Conteúdo informativo, sem caráter de aconselhamento jurídico. Encontrou um erro? [email protected].