DeepSeek, Kimi, GLM e MiniMax na advocacia: guia das IAs asiáticas de pesos abertos em novembro de 2026
Equipe Elden · · 19 min de leitura
Em resumo: Os laboratórios asiáticos cobram hoje os menores preços por token do mercado e quase todos publicam os pesos dos seus modelos, com o Kimi K3.1 Pro no topo do grupo (índice 46) e três versões Flash abaixo de US$ 0,60 por tarefa. Para uso em peça jurídica, qualquer um deles precisa consultar acervo oficial na hora da redação, e o caminho padrão para isso é o MCP.
Quais modelos asiáticos de pesos abertos entram neste guia?
Este guia cobre oito modelos de quatro laboratórios: DeepSeek V4.1 Flash 1017 e DeepSeek V4 Pro, Kimi K3 e Kimi K3.1 Pro (Moonshot AI), GLM-5.3 e GLM-5.3 Flash (Z.ai) e MiniMax M3 e MiniMax M3.1 Flash. O Qwen4-Max, da Alibaba, aparece só como referência cruzada, porque tem artigo próprio na série.
Índice e custo por tarefa vêm do leaderboard do Artificial Analysis. Os preços vêm do OpenRouter e das páginas oficiais dos fabricantes. Tudo foi conferido em 17/11/2026, com valores em dólares por milhão de tokens (US$/M).
| Laboratório | Modelo | Pesos | Contexto | Intelligence Index | Fabricante (entrada / saída, US$/M) | Faixa no OpenRouter (entrada, US$/M) |
|---|---|---|---|---|---|---|
| DeepSeek | V4.1 Flash 1017 | Abertos | 1M | 33 (Max) | 0,30 / 1,20 no horário de pico | 0,051 a 3,00 |
| DeepSeek | V4 Pro | Abertos | 1M | 23 (Max, versão 0813) | não publicado no OpenRouter | 0,90 a 1,95 |
| Moonshot AI | Kimi K3 | Abertos | 1M | não listado | 3,00 / 15,00 | 0,153 a 4,50 |
| Moonshot AI | Kimi K3.1 Pro | Abertos | 1M | 46 | 2,00 / 10,00 | 0,24 a 4,00 |
| Z.ai | GLM-5.3 | Abertos (licença própria) | 1M | 32 (Max) | 1,40 / 4,40 | 0,07 a 2,10 |
| Z.ai | GLM-5.3 Flash | Abertos (MIT) | 1M | 28 | 0,15 / 0,50 | 0,04 a 0,225 |
| MiniMax | M3 | Abertos | 1M | 19 | 0,30 / 1,20 | 0,224 a 0,45 |
| MiniMax | M3.1 Flash | Abertos | 1M | 29 | 0,15 / 0,60 | 0,075 a 0,15 |
| Alibaba (referência) | Qwen4-Max | Fechados | 1M | 43 | 1,425 / 4,275 (OpenRouter) | só a Alibaba listada |
O Qwen4-Max destoa do grupo: pesos fechados e acesso apenas pela API da Alibaba, ainda em pré-visualização. Ficha técnica, preço na QwenCloud e projeções estão em Qwen 4 e projeções.
Como DeepSeek, Kimi, GLM e MiniMax se comparam no Artificial Analysis?
No leaderboard do Artificial Analysis, o Kimi K3.1 Pro lidera o grupo com 46 pontos, acima do Qwen4-Max (43). Em seguida vem um bloco entre 28 e 33 pontos, com DeepSeek V4.1 Flash, GLM-5.3, MiniMax M3.1 Flash e GLM-5.3 Flash. DeepSeek V4 Pro (23) e MiniMax M3 (19) fecham a lista, abaixo das próprias versões Flash.
| Modelo (esforço) | Intelligence Index | Custo por tarefa (US$) | Tempo por tarefa (min) | Primeiro token (s) |
|---|---|---|---|---|
| Kimi K3.1 Pro | 46 | 3,68 | 38,9 | 152,69 |
| Qwen4-Max | 43 | 3,27 | 32,1 | 159,36 |
| DeepSeek V4.1 Flash 1017 (Max) | 33 | 0,60 | 13,0 | 40,43 |
| GLM-5.3 (Max) | 32 | 5,01 | 22,1 | 60,33 |
| MiniMax M3.1 Flash | 29 | 0,49 | 15,9 | 46,82 |
| GLM-5.3 Flash | 28 | 0,58 | 39,1 | 80,42 |
| DeepSeek V4 Pro 0813 (Max) | 23 | 1,77 | 17,3 | 50,00 |
| MiniMax M3 | 19 | 1,29 | 13,2 | 65,60 |
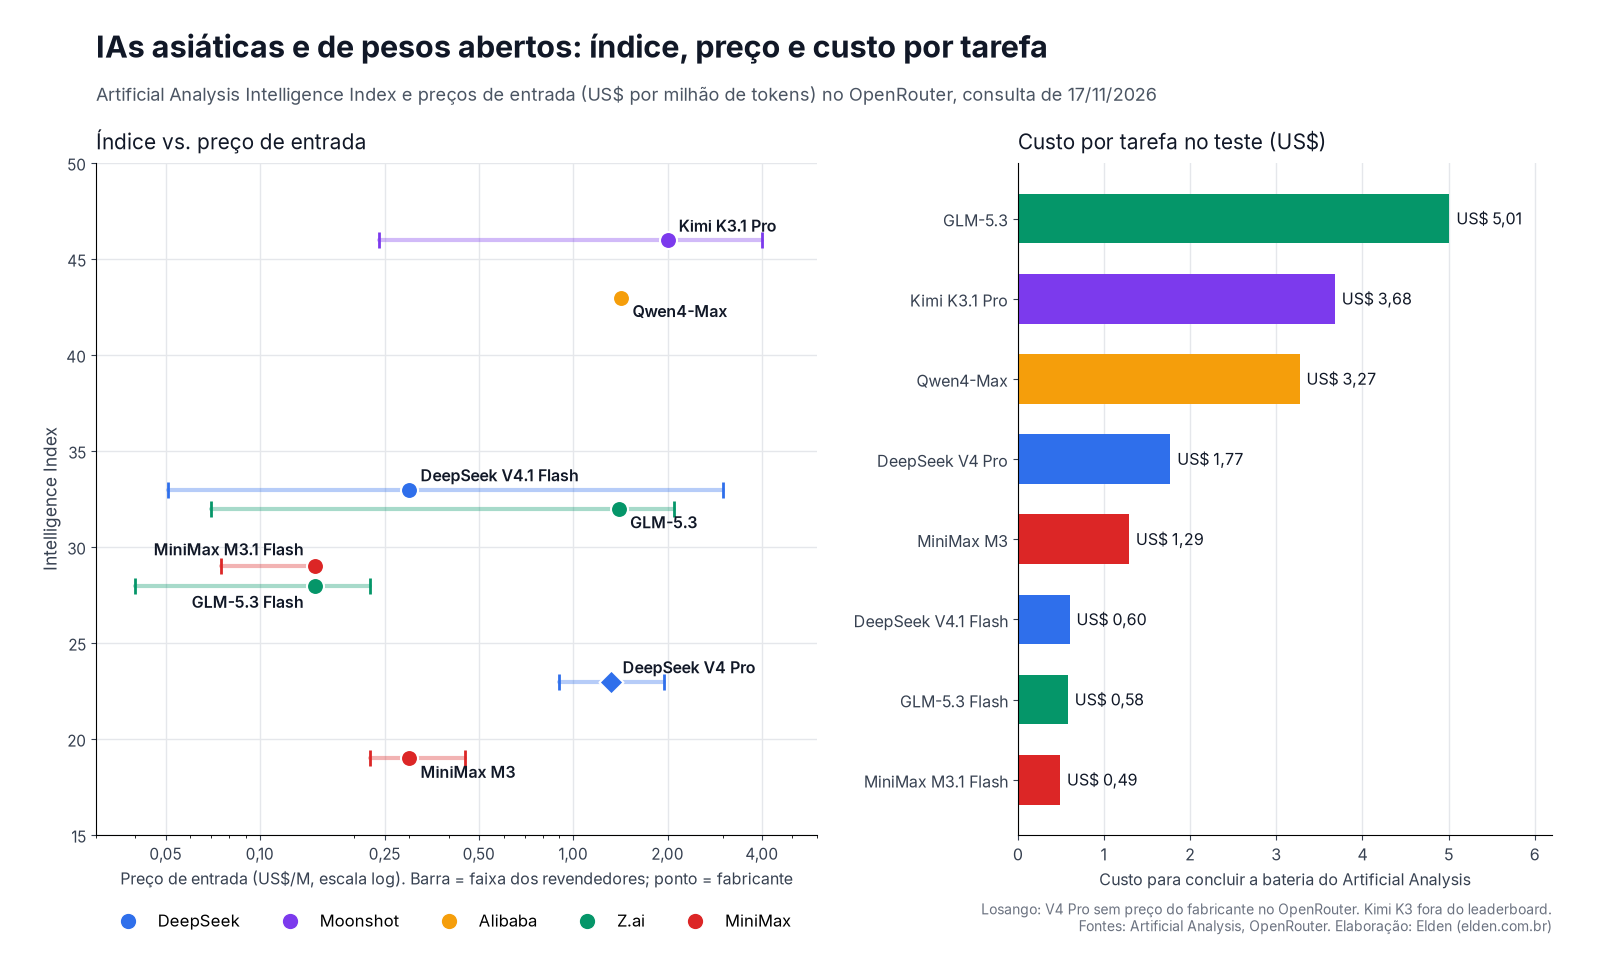
O gráfico tem duas metades. À esquerda, cada barra horizontal mostra a faixa de preço de entrada cobrada pelos revendedores no OpenRouter, e o ponto marca o preço do fabricante. À direita aparece o custo para concluir a bateria de testes do Artificial Analysis, já somados os tokens de raciocínio.
O GLM-5.3 ilustra por que as duas metades precisam ser lidas juntas. O preço por token é moderado, mas o custo por tarefa é o mais alto do grupo (US$ 5,01), porque o modelo gera muito raciocínio antes de responder. Na fatura do mês, pesa a tarefa concluída, não a tabela de tokens.
DeepSeek V4.1 Flash 1017 e DeepSeek V4 Pro: qual usar?
O DeepSeek V4.1 Flash 1017, atualização de 17 de outubro de 2026, é o modelo barato mais forte deste guia: índice 33, US$ 0,60 por tarefa e 13 minutos para concluir a bateria do Artificial Analysis. O DeepSeek V4 Pro, apesar do nome, fica dez pontos abaixo no índice e custa quase o triplo por tarefa.
| Item | V4.1 Flash 1017 | V4 Pro |
|---|---|---|
| Identificador na API oficial | deepseek-flash |
versão 0813 no Artificial Analysis; OpenRouter lista a 0423 |
| Entrada, horário de pico (US$/M) | 0,30 | não publicado no OpenRouter |
| Entrada, fora do pico (US$/M) | 0,15 | idem |
| Cache (pico / fora do pico, US$/M) | 0,006 / 0,003 | idem |
| Saída (pico / fora do pico, US$/M) | 1,20 / 0,60 | idem |
| Arquitetura divulgada | não informada | MoE com 1,6 trilhão de parâmetros, 49 bilhões ativos |
| Contexto | 1M | 1M |
Segundo a documentação da DeepSeek, os nomes antigos deepseek-v4-flash e deepseek-v4-flash-vision-exp continuam aceitos, mas apontam para o 1017 e são cobrados pelo preço do Flash. Quem mantém integração antiga já roda o modelo novo, talvez sem saber.
O V4 Pro 0813 é a versão estável de agosto, com um módulo de decodificação especulativa para reduzir a latência. O OpenRouter, porém, ainda lista a versão 0423, de abril. Antes de comparar resultados, confirme qual versão o revendedor serve de fato.
Na advocacia: o V4.1 Flash atende bem extração de dados de autos, resumo de publicações e primeira leitura de contratos. O V4 Pro só se justifica se um teste com casos do próprio escritório mostrar ganho real sobre o Flash, e o índice não aponta nessa direção.
Kimi K3 e Kimi K3.1 Pro: o que a Moonshot AI oferece?
O Kimi K3.1 Pro, da Moonshot AI, tem o maior índice entre os modelos de pesos abertos deste guia (46). É uma revisão do Kimi K3 com pós-treinamento bem mais extenso, voltado a reduzir erros factuais e a sustentar pesquisa, programação e tarefas profissionais longas. Os dois somam cerca de 2,8 trilhões de parâmetros e contexto de 1 milhão.
| Item | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Entrada / saída na Moonshot (US$/M) | 3,00 / 15,00 | 2,00 / 10,00 |
| Cache (US$/M) | 0,30 | consulte a tabela da Moonshot |
| Faixa no OpenRouter (entrada, US$/M) | 0,153 a 4,50 | 0,24 a 4,00 |
| Intelligence Index | não listado | 46 |
| Entradas | texto, imagem e vídeo | texto, imagem e vídeo |
| Amazon Bedrock | disponível | disponível, inclusive a variante Highspeed |
Há uma inversão curiosa: na própria Moonshot, o K3.1 Pro, mais novo e com índice maior, custa menos por token do que o K3. Para quem começa agora, não sobra razão técnica para escolher o K3.
A presença no Amazon Bedrock conta muito para escritórios e departamentos jurídicos que já operam na AWS. Ali o modelo roda dentro do perímetro de segurança e dos contratos da Amazon, com cache de prompt, chamada de ferramentas, saída estruturada e nível de raciocínio ajustável. A análise de LGPD fica mais simples, porque o fornecedor contratual é o mesmo da infraestrutura já aprovada.
A licença permite modificação e uso comercial, com acordo separado para grandes provedores de modelo como serviço acima de certo faturamento. Hospedar o K3.1 Pro em casa, contudo, exige servidor de data center: o arquivo de pesos passa de 1,5 terabyte.
Na advocacia: o K3.1 Pro é o candidato do grupo para trabalho que pede raciocínio, como análise de teses e minuta de recurso sobre autos extensos. O preço disso é a espera: quase 39 minutos por tarefa no teste e cerca de 2,5 minutos até o primeiro token. Funciona para tarefa em segundo plano, não para conversa em tempo real.
GLM-5.3 e GLM-5.3 Flash: o que muda entre os modelos da Z.ai?
A Z.ai, antiga Zhipu AI, lançou o GLM-5.3 e o GLM-5.3 Flash em 26 de agosto de 2026. O GLM-5.3 tem cerca de 753 bilhões de parâmetros (40 bilhões ativos) e mais de 40 revendedores no OpenRouter. O GLM-5.3 Flash tem 320 bilhões (18 bilhões ativos) e sai sob licença MIT, a mais simples do grupo.
| Item | GLM-5.3 | GLM-5.3 Flash | GLM-5.3 FlashX |
|---|---|---|---|
| Entrada (US$/M) | 1,40 | 0,15 | 0,37 |
| Cache (US$/M) | 0,26 | 0,03 | 0,075 |
| Saída (US$/M) | 4,40 | 0,50 | 1,25 |
| Faixa no OpenRouter (entrada, US$/M) | 0,07 a 2,10 | 0,04 a 0,225 | não comparado |
| Intelligence Index | 32 (Max) | 28 | não listado |
| Licença | própria, com restrições para grandes provedores | MIT | MIT |
A licença importa para quem pensa em hospedagem própria ou em oferecer o modelo a clientes. A MIT do Flash libera uso comercial sem outra exigência além de manter o aviso de copyright. A licença do GLM-5.3 pede leitura atenta antes de qualquer projeto que revenda acesso.
O ponto fraco do GLM-5.3 Flash é o tempo: 39,1 minutos por tarefa e 80 segundos até o primeiro token, os números mais altos entre os modelos baratos. Sai barato por tarefa (US$ 0,58), mas devagar.
Na advocacia: o GLM-5.3 Flash é a escolha natural para o escritório que quer um modelo dentro de casa, com licença sem surpresa, para triagem e anonimização de documentos antes de qualquer envio externo. O GLM-5.3 completo custa caro por tarefa para o índice que entrega.
MiniMax M3 e MiniMax M3.1 Flash: vale a versão de volume?
A MiniMax repete o padrão da DeepSeek, com a versão Flash à frente da principal. O MiniMax M3.1 Flash, lançado em 19 de outubro de 2026 e com pesos publicados dias depois, marca 29 no índice e tem o menor custo por tarefa deste guia (US$ 0,49). O MiniMax M3 marca 19 e custa US$ 1,29 por tarefa.
| Item | MiniMax M3 | MiniMax M3.1 Flash |
|---|---|---|
| Entrada / saída na MiniMax (US$/M) | 0,30 / 1,20 | 0,15 / 0,60 |
| Cache (US$/M) | consulte a tabela da MiniMax | 0,015 |
| Faixa no OpenRouter (entrada, US$/M) | 0,224 a 0,45 | 0,075 a 0,15 |
| Intelligence Index | 19 | 29 |
| Custo por tarefa (US$) | 1,29 | 0,49 |
| Arquitetura | MoE multimodal com atenção esparsa própria | MoE de 428 bilhões de parâmetros, 23 bilhões ativos |
O M3 estreou a MiniMax Sparse Attention, que escolhe blocos do contexto em vez de percorrer tudo de uma vez e barateia a leitura de textos longos. A ideia combina com autos volumosos, mas o índice do M3 ficou abaixo do resto do grupo.
Na advocacia: o M3.1 Flash disputa com o DeepSeek V4.1 Flash e o GLM-5.3 Flash a classificação de publicações, a extração de datas e partes e o resumo inicial de peças. Com 15,9 minutos por tarefa e 47 segundos até o primeiro token, é dos três o que equilibra preço e espera com mais folga.
Por que a versão Flash supera a versão Pro no índice?
Em dois laboratórios a versão de volume passou à frente da principal: MiniMax M3.1 Flash (29) contra MiniMax M3 (19), e DeepSeek V4.1 Flash (33) contra DeepSeek V4 Pro 0813 (23). A explicação é de calendário: as versões Flash são mais recentes e já incorporam técnicas de treino que os modelos maiores ainda não receberam.
O V4.1 Flash é de outubro; o V4 Pro 0813, de agosto. O M3.1 Flash é revisão posterior ao M3. Nos dois casos, o nome sugere uma hierarquia que o teste não confirma.
A lição para o escritório é direta: não escolha pelo nome. Compare índice, custo por tarefa e, sobretudo, o resultado em casos reais do seu acervo. A próxima versão Pro deve inverter o quadro outra vez, e por isso convém manter o fluxo preparado para trocar de modelo sem retrabalho.
Tarifa por horário da DeepSeek: quando rodar lotes de extração?
A DeepSeek cobra o dobro no horário de pico: de 01h a 04h e de 06h a 10h UTC, de segunda a sexta, exceto feriados chineses. No horário de Brasília (UTC-3), o pico cai entre 22h e 01h e entre 03h e 07h. Todo o expediente forense brasileiro fica, portanto, na faixa com 50% de desconto.
| Faixa | Horário UTC | Horário de Brasília | Entrada V4.1 Flash (US$/M) | Saída (US$/M) |
|---|---|---|---|---|
| Pico | 01h a 04h, dias úteis | 22h a 01h | 0,30 | 1,20 |
| Pico | 06h a 10h, dias úteis | 03h a 07h | 0,30 | 1,20 |
| Fora do pico | demais horários, fins de semana e feriados chineses | 07h a 22h e de 01h a 03h | 0,15 | 0,60 |
Isso contraria o hábito de agendar lotes de madrugada. Na DeepSeek, o lote noturno típico de um escritório brasileiro, disparado entre 22h e 07h, cai justamente no pico. Rodar a extração de dia, ou no fim de semana, sai pela metade.
No panorama de novembro também registramos cobrança por horário UTC no M3.1 Flash. A tabela padrão da MiniMax, porém, mostra hoje preço fixo de US$ 0,15 e US$ 0,60, e a variação aparece em planos e revendedores específicos. Antes de agendar lote grande em qualquer provedor, confira a tabela vigente na conta que será cobrada.
Exemplo de custo: triagem de mil publicações do DJEN, com cerca de 3 mil tokens de entrada e 300 de saída cada (3 milhões de entrada e 300 mil de saída no total), sem cache.
| Modelo | Custo estimado (US$) |
|---|---|
| GLM-5.3 Flash | 0,60 |
| MiniMax M3.1 Flash | 0,63 |
| DeepSeek V4.1 Flash, fora do pico | 0,63 |
| DeepSeek V4.1 Flash, no pico | 1,26 |
| GLM-5.3 | 5,52 |
| Kimi K3.1 Pro | 9,00 |
A conta considera só os tokens visíveis. Com raciocínio ligado, os modelos geram saída extra, e é por isso que o custo por tarefa do Artificial Analysis fica mais perto da fatura real.
OpenRouter ou hospedagem própria: como tratar quantização, retenção de dados e LGPD?
Pesos abertos permitem que qualquer empresa sirva o modelo, e por isso o mesmo DeepSeek V4.1 Flash aparece no OpenRouter de US$ 0,051 a US$ 3,00 por milhão de tokens de entrada. A diferença vai além da margem do revendedor: muda a precisão numérica, a política de retenção e o país onde os autos são processados.
Quantização. Revendedores reduzem a precisão dos pesos (de 16 bits para 8 ou 4, por exemplo) para servir mais barato. O modelo continua respondendo, mas tende a errar mais em tarefas longas e em detalhes como datas e números de processo. O OpenRouter informa a quantização de cada provedor na página do modelo e permite restringir a rota a provedores com precisão completa.
Retenção de dados. Cada revendedor tem política própria. Uns guardam prompts por algum tempo, outros declaram retenção zero, outros podem usar os dados para treino. O OpenRouter permite filtrar provedores por política de dados, mas o filtro só protege se alguém do escritório o configurar.
Hospedagem própria. Rodar o modelo em servidor do escritório, ou em nuvem contratada diretamente, tira o revendedor da cadeia. O investimento é alto para os modelos grandes (Kimi K3.1 Pro e GLM-5.3 exigem várias GPUs de data center), mas versões menores, como o GLM-5.3 Flash, cabem numa infraestrutura dedicada.
| Opção | Custo inicial | Controle sobre os dados | Risco de quantização | Indicação |
|---|---|---|---|---|
| API do fabricante | nenhum | contrato com empresa estrangeira | baixo | testes e volume sem dado sensível |
| Revendedor no OpenRouter, sem filtro | nenhum | varia por provedor | alto | evitar com autos reais |
| OpenRouter com filtro de precisão e retenção zero | nenhum | definido pela configuração | baixo | uso diário com dados anonimizados |
| Amazon Bedrock (Kimi) | nenhum | contrato com a AWS | baixo | escritórios que já usam AWS |
| Hospedagem própria | alto | total | definido por você | dados sensíveis e segredo de justiça |
Em qualquer opção a LGPD continua valendo. Enviar dados pessoais a servidor no exterior configura transferência internacional (arts. 33 a 36 da Lei 13.709/2018), e anonimizar nome, CPF e endereço antes do envio raramente prejudica a análise jurídica.
Onde cada modelo asiático rende na rotina do escritório de advocacia?
Nenhum modelo de DeepSeek, Moonshot AI, Z.ai ou MiniMax cobre sozinho todas as tarefas de um escritório com bom custo-benefício. A divisão mais racional usa um modelo Flash barato para o volume diário, o Kimi K3.1 Pro para raciocínio pesado em segundo plano e um modelo pequeno hospedado em casa para dado sensível.
| Tarefa | Modelo indicado | Por quê |
|---|---|---|
| Classificação de publicações e intimações | MiniMax M3.1 Flash ou DeepSeek V4.1 Flash | menor custo por tarefa e espera curta |
| Extração de dados de autos e extratos | DeepSeek V4.1 Flash, fora do pico | índice 33 pela metade do preço no expediente |
| Anonimização antes de envio externo | GLM-5.3 Flash hospedado em casa | licença MIT e porte viável |
| Análise de teses e minuta de recurso | Kimi K3.1 Pro | maior índice do grupo |
| Ambiente corporativo na AWS | Kimi K3.1 Pro no Bedrock | contrato e perímetro já aprovados |
| Agente de horizonte longo com autos inteiros | Qwen4-Max ou Kimi K3.1 Pro | ver Qwen 4 e projeções |
Em todas as linhas vale a mesma condição: a citação de jurisprudência não pode sair da memória do modelo. É nesse ponto que entra o acervo oficial.
Como ligar DeepSeek, Kimi, GLM e MiniMax ao Elden via MCP?
Nenhum modelo de DeepSeek, Moonshot AI, Z.ai ou MiniMax conhece a jurisprudência brasileira atualizada, e os de pesos abertos costumam ter pouco material jurídico em português no treino. O Elden fecha essa lacuna com um conector MCP em https://elden.com.br/mcp, que liga o modelo a mais de 20 milhões de acórdãos oficiais.
O MCP (Model Context Protocol) é um padrão aberto, e por isso o acervo do Elden não fica preso a um fornecedor. O mesmo conector atende o Kimi pela API da Moonshot ou pelo Bedrock, o DeepSeek pela API oficial, o GLM rodando no servidor do escritório ou qualquer modelo roteado pelo OpenRouter. Basta um cliente ou agente compatível com MCP remoto.
O fluxo de trabalho fica assim:
- O modelo lê os autos e delimita a questão jurídica.
- O agente consulta o Elden via MCP, que pesquisa acórdãos do STF, do STJ, dos TJs e dos TRFs, as publicações do DJEN e a legislação do Planalto.
- A busca passa pela primeira geração de IAs próprias do Elden, de rerank e de embedding, treinadas em texto jurídico brasileiro, que ordenam os acórdãos por pertinência.
- O modelo recebe o texto com a origem e redige a partir da fonte, não da memória.
- O advogado confere cada citação antes de assinar.
Esse desenho conversa com a lógica de custo do grupo. Em vez de colar dezenas de acórdãos no contexto e pagar por todos esses tokens, o modelo recebe só os precedentes pertinentes, o que reduz a entrada e o risco de citação inventada.
| Plano Elden | Preço | O que inclui |
|---|---|---|
| Grátis | R$ 0, permanente e sem cartão | acervo completo via MCP, com uso limitado da pesquisa aprofundada |
| Essencial | R$ 29,90/mês | pesquisa aprofundada maior; 5 estilos próprios de peça, inclusive criados a partir de PDF seu; memória de até 100 anotações; adiantamento de uso quando você precisa terminar uma peça |
| Profissional | R$ 69,90/mês | pesquisa aprofundada no nível máximo; 5 vezes o uso; 20 estilos próprios de peça, inclusive criados a partir de PDF seu; memória de até 5.000 anotações |
Os estilos próprios importam para quem usa modelo aberto: o Kimi ou o DeepSeek escrevem no formato do escritório sem que você cole a peça modelo a cada pedido. A memória guarda dados recorrentes, como a vara de preferência ou a tese padrão de um tipo de ação.
A documentação e os manifestos de conexão para cada cliente estão no repositório público do Elden no GitHub. Para começar, crie a conta em elden.com.br/criar-conta, ligue o conector ao seu cliente e teste com um caso real anonimizado: peça os precedentes primeiro sem o conector e depois com ele, e compare as fontes.
O que esperar das famílias asiáticas de pesos abertos nos próximos meses?
DeepSeek, Moonshot AI, Z.ai, MiniMax e Alibaba lançam revisões a cada dois ou três meses, o ritmo mais acelerado do mercado. A tendência aponta para preço por token ainda menor, mais versões Flash com índice próximo das principais e licenças cada vez mais variadas, o que exige leitura jurídica antes de cada adoção.
Projeções com base no que os laboratórios já sinalizaram:
- DeepSeek: uma revisão do V4 Pro deve recolocar a versão principal acima do Flash. A cobrança por horário tende a continuar, com o expediente brasileiro na faixa barata.
- Moonshot AI: a variante Highspeed no Bedrock indica modelos grandes com resposta mais rápida, hoje o ponto fraco do K3.1 Pro.
- Z.ai: a linha FlashX, entre o Flash e o modelo completo, desenha uma família em três degraus de preço, como já fazem os laboratórios americanos.
- MiniMax: a atenção esparsa deve chegar à próxima versão principal, com foco em autos longos a custo baixo.
- Alibaba: as variantes abertas da família Qwen 4, anunciadas sem data, devem entrar na disputa da hospedagem própria.
Com tanta troca de modelo, a estabilidade do escritório vem do que não muda: um fluxo montado sobre padrões abertos e o acervo oficial plugado via MCP. O modelo da vez pode mudar a cada trimestre; a fonte da citação precisa continuar a mesma.
Fontes
Elden:
- https://elden.com.br
- https://elden.com.br/mcp
- https://elden.com.br/criar-conta
- https://github.com/magmonte/elden-mcp
Avaliação independente e preços:
- https://artificialanalysis.ai/leaderboards/models
- https://artificialanalysis.ai/models
- https://openrouter.ai/models
- https://openrouter.ai/deepseek/deepseek-v4.1-flash
- https://openrouter.ai/deepseek/deepseek-v4-pro
- https://openrouter.ai/moonshotai/kimi-k3
- https://openrouter.ai/moonshotai/kimi-k3.1-pro
- https://openrouter.ai/z-ai/glm-5.3
- https://openrouter.ai/z-ai/glm-5.3-flash
- https://openrouter.ai/minimax/minimax-m3
- https://openrouter.ai/minimax/minimax-m3.1-flash
- https://openrouter.ai/qwen/qwen4-max
Documentação oficial dos fabricantes:
- https://api-docs.deepseek.com/quick_start/pricing
- https://huggingface.co/deepseek-ai
- https://platform.moonshot.ai/docs/pricing
- https://aws.amazon.com/bedrock/moonshot/
- https://docs.z.ai/guides/overview/pricing
- https://huggingface.co/zai-org
- https://www.minimax.io/platform/pricing
- https://huggingface.co/MiniMaxAI
Legislação:
- https://www.planalto.gov.br/ccivil_03/_ato2015-2018/2018/lei/l13709.htm
Série Elden sobre famílias de IA:
- https://elden.com.br/blog/familias-de-modelos-ia-novembro-2026/
- https://elden.com.br/blog/qwen-4-e-futuras-projecoes-ia-juridica/
Um conector que leva leis, súmulas e decisões dos tribunais brasileiros para dentro do ChatGPT, Claude ou Gemini, com número e link. Tem plano grátis permanente.
Sobre este texto: produzido com auxílio de inteligência artificial a partir das fontes indicadas, com conferência automática de números, tribunais e links. Conteúdo informativo, sem caráter de aconselhamento jurídico. Encontrou um erro? [email protected].