GPT-6 na advocacia: Astra, Sol, Terra, Luna e GPT-5.5 comparados em preço, contexto e uso no escritório
Equipe Elden · · 13 min de leitura
Em resumo: O GPT-6.1 Sol empata com o Claude Sonnet 5.5 no Intelligence Index do Artificial Analysis (55) gastando US$ 1,27 por tarefa, e o GPT-6.1 Terra chega a 51 por US$ 0,96, o que faz dos dois o centro de custo mais eficiente da família OpenAI para peças jurídicas. O número que mais pesa no orçamento, porém, é o limite de 272 mil tokens de entrada, acima do qual a requisição inteira passa a custar o dobro na entrada e 1,5 vez na saída (dados conferidos em 17/11/2026).
Quais modelos formam a família OpenAI GPT em novembro de 2026?
A família OpenAI GPT tem cinco modelos ativos na API em novembro de 2026. A linha GPT-6 traz o GPT-6 Astra no topo e o GPT-6 Luna na base. A revisão 6.1 entregou o GPT-6.1 Sol, na faixa intermediária, e o GPT-6.1 Terra, na faixa econômica. O GPT-5.5 segue disponível para integrações que já rodam sobre ele.
| Modelo | Faixa | Identificador na API | Contexto / entrada máx. / saída (tokens) | Intelligence Index (esforço) |
|---|---|---|---|---|
| GPT-6 Astra | Topo de linha | gpt-6-astra |
1.050.000 / 922.000 / 128.000 | 57 (Max) |
| GPT-5.5 | Geração anterior | gpt-5.5 |
não informado na página de preços | não listado |
| GPT-6.1 Sol | Intermediário | gpt-6.1-sol |
1.050.000 / 922.000 / 128.000 | 55 (Max) |
| GPT-6.1 Terra | Econômico | gpt-6.1-terra |
1M (segundo o Artificial Analysis) | 51 (Max) |
| GPT-6 Luna | Volume | gpt-6-luna |
1M (segundo o Artificial Analysis) | 28 (Max) |
A nomenclatura merece atenção antes de qualquer integração. O modelo de volume se chama GPT-6 Luna, sem a revisão 6.1, e chamadas a gpt-6.1-luna retornam erro. O inverso vale para Sol e Terra: "GPT-6 Sol" e "GPT-6 Terra" não existem, porque os dois nasceram já na revisão 6.1.
Astra e Sol têm corte de conhecimento em 30/04/2026 e cinco níveis de esforço de raciocínio: low, medium, high, xhigh e max. O GPT-5.5 mantém a escala da geração anterior, de none a xhigh. Cada degrau a mais de esforço consome mais tokens de raciocínio antes da resposta, e esses tokens entram na conta como saída. Em peça longa, a diferença entre high e max aparece na fatura.
Quanto custa cada modelo GPT por milhão de tokens?
Na faixa padrão, válida para prompts de até 272 mil tokens de entrada, o GPT-6 Astra cobra US$ 10 por milhão de tokens na entrada e US$ 50 na saída, o preço mais alto entre os grandes provedores. O GPT-6.1 Sol custa um quinto disso, o GPT-6.1 Terra a metade do Sol, e o GPT-6 Luna fica em centavos.
| Modelo | Entrada (US$/M) | Saída (US$/M) | Cache (US$/M) | Batch e Flex (entrada / saída) | Fast (entrada / saída) |
|---|---|---|---|---|---|
| GPT-6 Astra | 10,00 | 50,00 | 1,00 | 5,00 / 25,00 | 20,00 / 100,00 |
| GPT-5.5 | 5,00 | 30,00 | 0,50 | 2,50 / 15,00 | 10,00 / 60,00 |
| GPT-6.1 Sol | 2,00 | 10,00 | 0,10 | 1,00 / 5,00 | 4,00 / 20,00 |
| GPT-6.1 Terra | 1,00 | 5,00 | 0,05 | 0,50 / 2,50 | 2,00 / 10,00 |
| GPT-6 Luna | 0,10 | 0,50 | 0,01 | 0,05 / 0,25 | 0,20 / 1,00 |
Os modos alternativos mudam o preço em proporções fixas. Batch e Flex custam metade do padrão: o Batch devolve o resultado em até 24 horas, adequado para lotes noturnos de leitura de publicações, e o Flex usa capacidade ociosa, com latência maior em horário de pico. O modo Fast, que substituiu o antigo Priority, cobra o dobro para reservar capacidade de resposta rápida.
O cache de leitura custa 10% da entrada no Astra e no GPT-5.5 e 5% no Sol, no Terra e no Luna. Isso muda a economia de quem trabalha sobre os mesmos autos várias vezes: no Sol, a primeira leitura de um processo custa US$ 2,00 por milhão de tokens, e as consultas seguintes ao mesmo trecho em cache saem por US$ 0,10.
O que acontece com o preço do GPT acima de 272 mil tokens?
Quando o prompt enviado a um modelo GPT passa de 272 mil tokens de entrada, a OpenAI aplica a tabela de contexto longo à requisição inteira: o dobro na entrada e no cache, 1,5 vez na saída. A cobrança não incide só sobre o excedente. Um pedido de 280 mil tokens paga o preço alto em todos os 280 mil.
| Modelo | Entrada até 272k | Entrada acima de 272k | Saída até 272k | Saída acima de 272k | Cache acima de 272k |
|---|---|---|---|---|---|
| GPT-6 Astra | 10,00 | 20,00 | 50,00 | 75,00 | 2,00 |
| GPT-5.5 | 5,00 | 10,00 | 30,00 | 45,00 | 1,00 |
| GPT-6.1 Sol | 2,00 | 4,00 | 10,00 | 15,00 | 0,20 |
| GPT-6.1 Terra | 1,00 | 2,00 | 5,00 | 7,50 | 0,10 |
| GPT-6 Luna | 0,10 | 0,20 | 0,50 | 0,75 | 0,02 |
Valores em US$ por milhão de tokens. A entrada acima de 272 mil consta da tabela de contexto longo da OpenAI. Saída e cache de Terra, Luna e GPT-5.5 nessa faixa foram calculados com os multiplicadores oficiais (1,5 vez e 2 vezes).
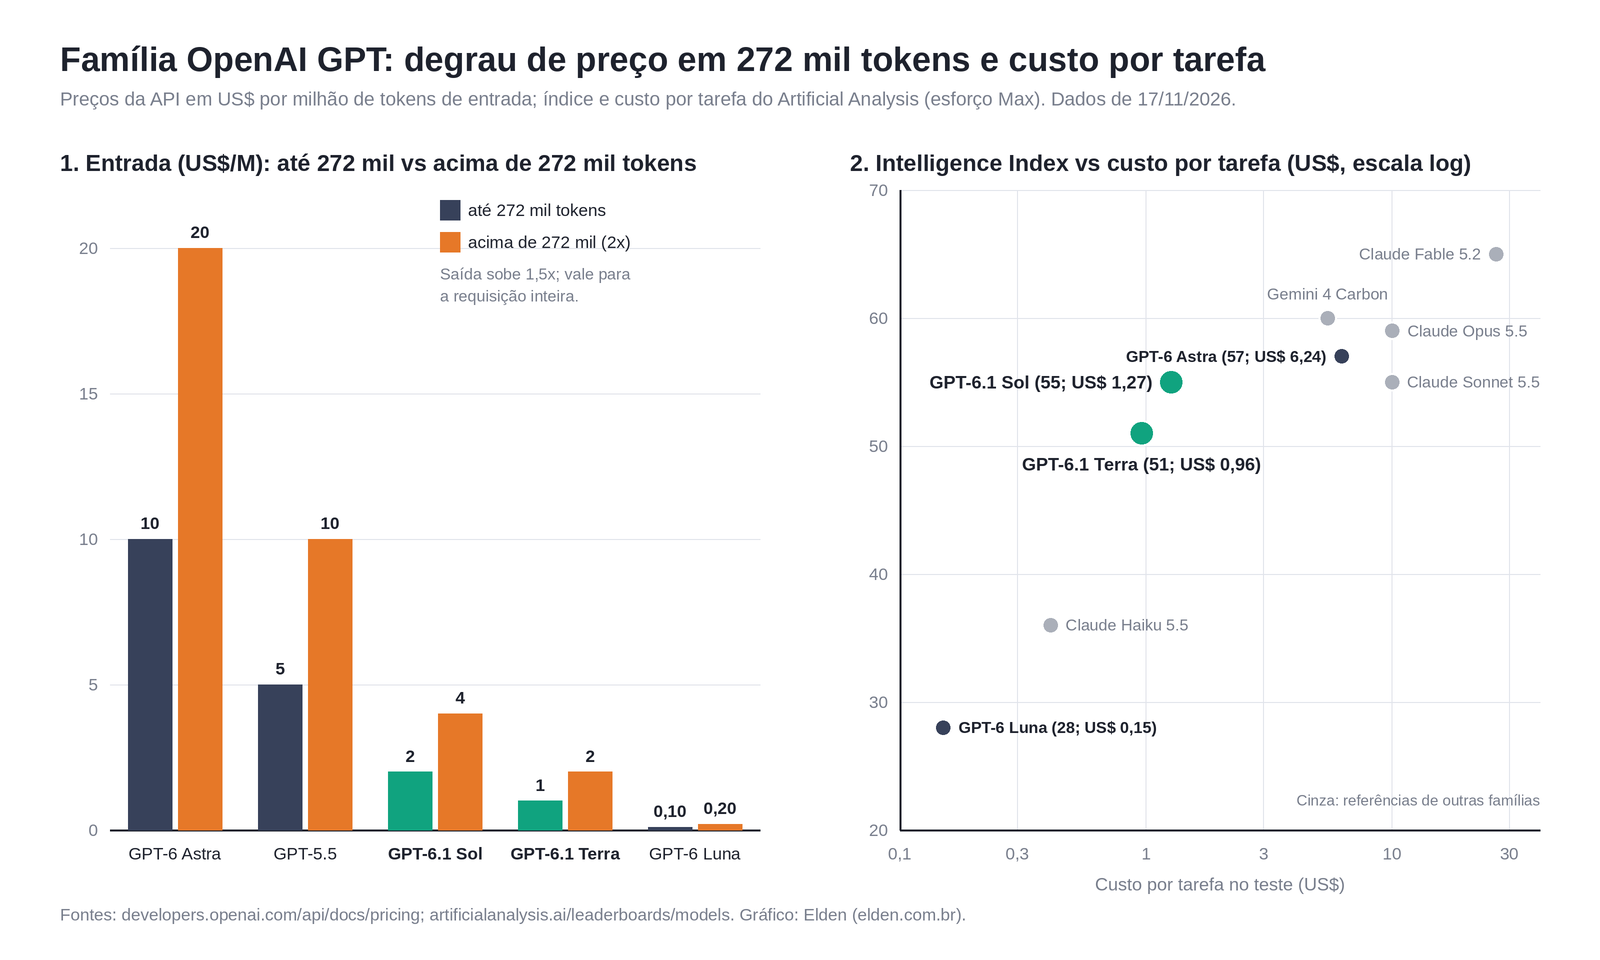
Um exemplo com números redondos mostra o tamanho do degrau. Enviar 270 mil tokens de autos ao Astra e receber 10 mil de resposta custa US$ 3,20 (US$ 2,70 de entrada e US$ 0,50 de saída). Enviar 300 mil tokens, com a mesma resposta, custa US$ 6,75. São 11% a mais de texto e mais que o dobro do preço. No Sol, a mesma comparação vai de US$ 0,64 para US$ 1,35.
A regra prática para o escritório decorre daí. Processos volumosos devem ser divididos em blocos abaixo de 272 mil tokens, por exemplo petição inicial e contestação num pedido, provas e decisões em outro, com o cache cobrindo as partes repetidas. A janela de 1,05 milhão de tokens existe, mas preenchê-la de uma vez é a forma mais cara de usá-la.
Como os modelos GPT se comparam no Artificial Analysis?
No leaderboard do Artificial Analysis de 17/11/2026, o GPT-6 Astra ocupa o quarto lugar, com índice 57, atrás do Claude Fable 5.2, do Gemini 4 Carbon e do Claude Opus 5.5. O dado decisivo está no custo por tarefa: o GPT-6.1 Sol chega a 55 gastando US$ 1,27, cerca de oito vezes menos que o Claude Sonnet 5.5.
| Modelo (esforço Max) | Intelligence Index | Custo por tarefa (US$) | Tempo por tarefa (min) | Primeiro token (s) |
|---|---|---|---|---|
| GPT-6 Astra | 57 | 6,24 | 20,2 | 198,40 |
| GPT-6.1 Sol | 55 | 1,27 | 22,7 | 156,92 |
| GPT-6.1 Terra | 51 | 0,96 | 13,9 | 148,01 |
| GPT-6 Luna | 28 | 0,15 | 12,2 | 68,75 |
| Claude Sonnet 5.5 (referência) | 55 | 10,02 | 31,1 | 283,74 |
| Claude Haiku 5.5 (referência) | 36 | 0,41 | 14,7 | 184,29 |
| Gemini 4 Carbon, High (referência) | 60 | 5,48 | 31,8 | 72,30 |
O GPT-5.5 na versão padrão não constava no leaderboard na data da consulta. Entre os modelos GPT com índice acima de 50, o Terra tem o menor tempo por tarefa (13,9 minutos). O Luna é barato, mas fica oito pontos abaixo do Haiku 5.5, e precisa de teste próprio antes de assumir qualquer tarefa que envolva interpretação.
O tempo até o primeiro token passa de dois minutos em Astra, Sol e Terra no esforço Max. Para atendimento em tempo real, como a triagem de um cliente que escreve pelo site, o caminho é baixar o esforço para medium ou low e medir de novo, aceitando alguma perda de profundidade em troca de uma resposta que chega enquanto o cliente ainda está na página.
Onde cada modelo GPT rende no escritório de advocacia?
Cada modelo da família OpenAI GPT atende um tipo de trabalho jurídico. O GPT-6 Astra se justifica em casos de alto valor, o GPT-6.1 Sol cobre a maior parte das peças, o GPT-6.1 Terra atende rotinas frequentes que pedem raciocínio, e o GPT-6 Luna fica com classificação em massa. O GPT-5.5 interessa a quem ainda não validou a migração.
| Tarefa | Modelo indicado | Por quê |
|---|---|---|
| Recurso especial, parecer, estratégia de caso complexo | GPT-6 Astra | Maior índice da OpenAI (57); custo por tarefa alto, compensado pelo valor da causa |
| Petição inicial, contestação, apelação, memorial | GPT-6.1 Sol | Índice 55 por US$ 1,27 por tarefa; preço por token igual ao do Sonnet 5.5 |
| Resumo de decisões, manifestação simples, revisão de contrato padrão | GPT-6.1 Terra | Índice 51, menor tempo por tarefa da faixa, metade do preço do Sol |
| Classificação de intimações, extração de prazos, etiquetagem de documentos | GPT-6 Luna | US$ 0,10 por milhão de entrada; rende em Batch, com revisão por amostragem |
| Fluxos antigos já homologados | GPT-5.5 | Evita retrabalho imediato; o Sol custa menos e merece teste paralelo |
Em escritórios com volume, uma divisão em três camadas costuma funcionar. O Luna, em Batch, separa as publicações do dia. O Terra resume as que pedem providência e aponta o prazo. O Sol redige a peça. O Astra entra quando o sócio responsável decide que o caso pede a análise mais profunda disponível na OpenAI, e o custo extra cabe no valor em disputa.
Em qualquer camada, a revisão humana do prazo extraído continua obrigatória. Um modelo que classifica bem 98 de cada 100 intimações ainda erra duas, e no contencioso uma intimação mal lida pode significar preclusão.
Quais são as projeções para a família OpenAI GPT?
A trajetória recente da OpenAI indica revisões frequentes e preço por token estável ou em queda nas faixas média e econômica. A revisão 6.1 chegou ao GPT-6.1 Sol e ao GPT-6.1 Terra, mas não ao GPT-6 Astra nem ao GPT-6 Luna, que devem ser os próximos atualizados. O GPT-5.5 tende a ser descontinuado.
Três pontos merecem acompanhamento nos próximos meses:
- Limite de 272 mil tokens. Ele se manteve de uma geração para outra. Se a OpenAI ampliar o limite, como Google e Anthropic já fazem ao cobrar o contexto de 1 milhão pelo preço padrão em vários modelos, Astra e Sol ficam mais competitivos para a leitura de autos inteiros.
- Revisão 6.1 do Luna. O Luna tem o índice mais baixo da família (28). Uma revisão que o aproxime do Muse Ember ou do Claude Haiku 5.5 (ambos com 36) mudaria a escolha para triagem em massa.
- Saída do GPT-5.5. Quem ainda roda sobre ele deve planejar a migração para o Sol, que custa menos por token e tem índice publicado.
Há um limite que nenhuma revisão resolve sozinha. O corte de conhecimento em abril de 2026 deixa de fora precedentes recentes, e nenhum modelo da família entrega número de processo ou ementa confiável quando trabalha só com a memória do treino. A precisão em peça jurídica depende de acervo oficial consultado no momento da redação.
Como ligar o ChatGPT e a API da OpenAI ao Elden via MCP?
O Elden conecta o ChatGPT e a API da OpenAI, pelo endereço https://elden.com.br/mcp, a mais de 20 milhões de acórdãos do STF, do STJ, dos Tribunais de Justiça e dos Tribunais Regionais Federais, recebidos via DJEN, e à legislação publicada no Planalto. O modelo GPT responde com base nesse acervo, e cada citação pode ser conferida na fonte.
A busca do Elden usa a primeira geração de IAs próprias de rerank e embedding, treinadas sobre o texto jurídico brasileiro. Na prática, isso significa que a consulta "prazo prescricional na cobrança de seguro" chega aos acórdãos que tratam do tema mesmo quando o tribunal usou outras palavras, e que os resultados mais pertinentes aparecem primeiro.
No ChatGPT web. Conectores MCP personalizados funcionam no navegador nos planos Pro, Business, Enterprise e Edu, pelo modo de desenvolvedor. Os planos Free e Plus ficam de fora, assim como o aplicativo. O passo a passo:
- Abra o ChatGPT no navegador e ative o modo de desenvolvedor nas configurações.
- Na área de conectores, escolha adicionar servidor MCP personalizado.
- Informe o nome "Elden" e a URL
https://elden.com.br/mcp, e faça login com sua conta do Elden. - Na conversa, selecione o conector pelo menu
+e peça a pesquisa de jurisprudência.
Em Business, Enterprise e Edu, o administrador do workspace precisa liberar conectores personalizados antes que a opção apareça para os usuários.
Na API da OpenAI. A Responses API aceita servidores MCP remotos como ferramenta. Um exemplo em Python com o Sol:
from openai import OpenAI

client = OpenAI()
resposta = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "high"},
    tools=[{
        "type": "mcp",
        "server_label": "elden",
        "server_url": "https://elden.com.br/mcp",
        "require_approval": "never",
    }],
    input="Pesquise no Elden acórdãos recentes do STJ sobre prazo prescricional em ação de cobrança de seguro e cite o número de cada processo.",
)
print(resposta.output_text)
Os manifestos de conexão para cada cliente MCP estão em https://github.com/magmonte/elden-mcp.
| Plano do Elden | Preço | O que inclui |
|---|---|---|
| Grátis | R$ 0, permanente, sem cartão | Acesso ao acervo via MCP, com uso limitado da pesquisa aprofundada |
| Essencial | R$ 29,90/mês | Pesquisa aprofundada maior; 5 estilos próprios de peça, inclusive criados a partir de um PDF seu; memória de até 100 anotações; adiantamento de uso quando você precisa terminar uma peça |
| Profissional | R$ 69,90/mês | Pesquisa aprofundada máxima; 5 vezes o uso do Essencial; 20 estilos próprios, inclusive a partir de PDF seu; memória de até 5.000 anotações |
Para começar, crie a conta gratuita em https://elden.com.br/criar-conta e teste o conector com o modelo GPT que você já usa. Uma boa primeira prova é pedir ao Sol que pesquise um tema da sua área e conferir, no próprio Elden, se cada número de processo citado existe e diz o que a resposta afirma.
Fontes
Os preços vêm da página oficial de preços da API da OpenAI e das fichas de cada modelo. Índice, custo e tempo por tarefa vêm do leaderboard do Artificial Analysis, consultado em 17/11/2026. As regras de conectores MCP seguem a central de ajuda e a documentação da OpenAI para desenvolvedores.
- https://developers.openai.com/api/docs/pricing
- https://developers.openai.com/api/docs/models/gpt-6-astra
- https://developers.openai.com/api/docs/models/gpt-6.1-sol
- https://developers.openai.com/api/docs/guides/tools-connectors-mcp
- https://help.openai.com/en/articles/12584461-developer-mode-apps-and-full-mcp-connectors-in-chatgpt-beta
- https://openrouter.ai/openai/gpt-6-astra
- https://openrouter.ai/models
- https://artificialanalysis.ai/leaderboards/models
- https://artificialanalysis.ai/models
- https://elden.com.br
- https://elden.com.br/criar-conta
- https://github.com/magmonte/elden-mcp
Um conector que leva leis, súmulas e decisões dos tribunais brasileiros para dentro do ChatGPT, Claude ou Gemini, com número e link. Tem plano grátis permanente.
Sobre este texto: produzido com auxílio de inteligência artificial a partir das fontes indicadas, com conferência automática de números, tribunais e links. Conteúdo informativo, sem caráter de aconselhamento jurídico. Encontrou um erro? [email protected].